Tavus Griffin: أول ذكاء اصطناعي يجتاز اختبار تورنغ للفيديو
يُعد Tavus Griffin نموذج فيديو تفاعلي بالذكاء الاصطناعي مصممًا لإجراء مكالمات فيديو في الوقت الفعلي مع تبادل أدوار الحديث بحركات وجه سلسة واستجابة صوتية بأقل من ثانية. أظهرت تجارب حية حديثة أن 48٪ من المشاركين اعتقدوا أن الشخصية الافتراضية كانت إنسانًا حقيقيًا بعد تفاعل دام 60 ثانية.
يمثل Tavus Griffin نقلة ملحوظة في مجال الوسائط التوليدية بخوضه اختبار تورنغ للفيديو المباشر والمصمم لتقييم الواقعية التفاعلية. تم تطوير Griffin بواسطة Tavus كبنية نموذجية تفاعلية متقدمة لدعم شخصيات رقمية تتحدث وتستمع وتتفاعل أثناء مكالمات الفيديو ثنائية الاتجاه.
تنتج نماذج الفيديو التقليدية المشاهد بالتتابع انطلاقًا من أوامر نصية أو صور ثابتة. أما Griffin فيعمل بشكل مختلف؛ إذ يبث تعبيرات وجه سلسة، وحوارًا منطوقًا، وردود فعل دقيقة في وقت واحد بالتزامن مع معالجة المدخلات الصوتية من المتحدث في الوقت الفعلي.
تهدف هذه التقنية، التي أُعلن عنها في 1 أكتوبر 2026، إلى سد الفجوة بين المقاطع التوليدية المسجلة مسبقًا وتفاعلات الفيديو الفورية. فهي تُحاكي التعبيرات الدقيقة للوجه وتضبط إيقاع الصوت بدقة لتمكين المتحدثين الرقميين من إدارة محادثات فيديو طويلة بإيقاع طبيعي.
كيف قيّم الاختبار المعياري نموذج Tavus Griffin مقارنةً بالبشر؟
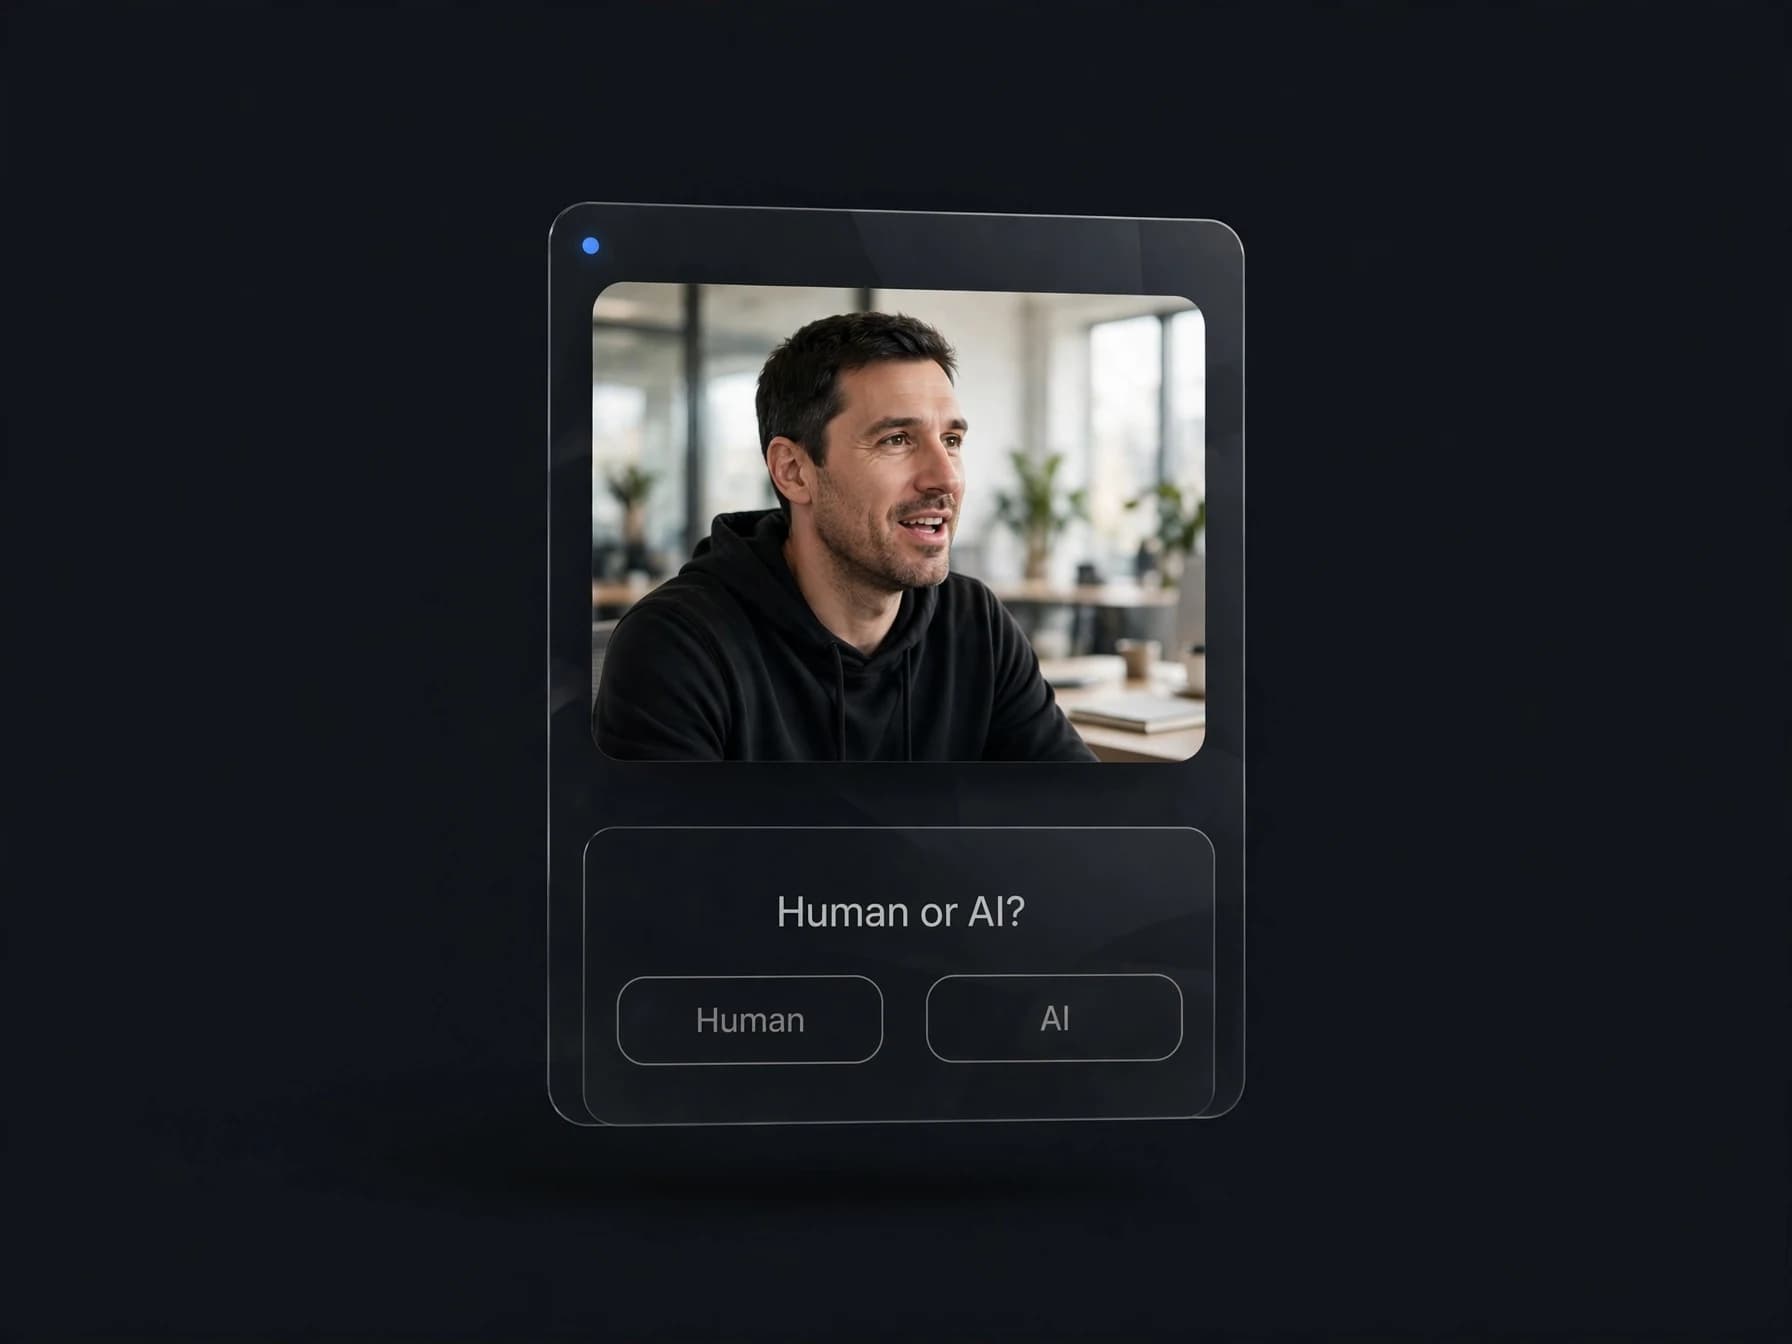
خلال تقييم صارم لاختبار تورنغ للذكاء الاصطناعي، اختبر الباحثون ما إذا كان المشاهدون العاديون قادرين على التمييز بين نظام آلي وشخص حقيقي في الوقت الفعلي. وفي تجربة مكالمة فيديو مباشرة لمدة دقيقة واحدة بمشاركة 54 شخصًا، اعتقد 48 بالمائة أنهم يتحدثون مع إنسان حقيقي. بالمقارنة، أقنعت التقنية السابقة من Tavus ما نسبته 2.4 بالمائة فقط من المشاركين، أي مُقيّمًا واحدًا من أصل 41.
كما حصد النظام المركز الأول في المعيار التفاعلي NVIDIA VideoFDB؛ إذ سجل 3.83 في واقعية التوليد مقارنة بـ 3.92 للفيديو البشري، إلى جانب تقييم إدراك بلغ 3.73 مقابل 4.20 للأداء البشري.
توضح هذه الأرقام أن توليد الفيديو في الوقت الفعلي يقترب من التماثل البصري في التفاعلات القصيرة. ومع أن المحادثات الطويلة لا تزال تكشف بعض العيوب المصطنعة، إلا أن الحوارات السريعة باتت تُحاكي الحضور البشري الحقيقي بدرجة ملحوظة ومثبتة.
مكالمة فيديو مباشرة مع بطاقة استطلاع تسأل المشاهدين عما إذا كان المتحدث إنسانًا أم ذكاءً اصطناعيًا
بنية البث المباشر وراء وكلاء فيديو الذكاء الاصطناعي التفاعليين
يتطلب تشغيل شخصية افتراضية تفاعلية بالذكاء الاصطناعي مزامنة توليد إطارات الفيديو مع الإشارات التفاعلية الفورية. تنسق Tavus هذه التجربة عبر أنظمة متخصصة ومتميزة تتولى الفهم، وتوقيت الكلام، والمخرجات البصرية.
يستخدم النظام Raven-1 للإدراك الحسي وSparrow-2 لإدارة تبادل أدوار الحديث والتعامل مع المقاطعة. تتم المعالجة المرئية بواسطة Phoenix-4.5 بمعدل تأخير منخفض يبلغ نحو 134 ميلي ثانية، بينما يمنح Tavus Griffin محاكاة دقيقة للوجه وتكيفًا مستمرًا مع البيئة المحيطة.
تتيح هذه البنية للمطورين إنشاء وكلاء تفاعليين يتوقفون عند مقاطعتهم ويستأنفون الكلام بطبيعية. وفي حين تركز أدوات صُنّاع المحتوى مثل صانع الشخصيات الافتراضية بالذكاء الاصطناعي على إنتاج فيديوهات متحدثة مسجلة مسبقًا وبجودة عالية من الصور، تركز البنى التفاعلية بالكامل على البث المباشر بأقل زمن استجابة.
طريقة تجربة Tavus Griffin ومدى توفره الحالي
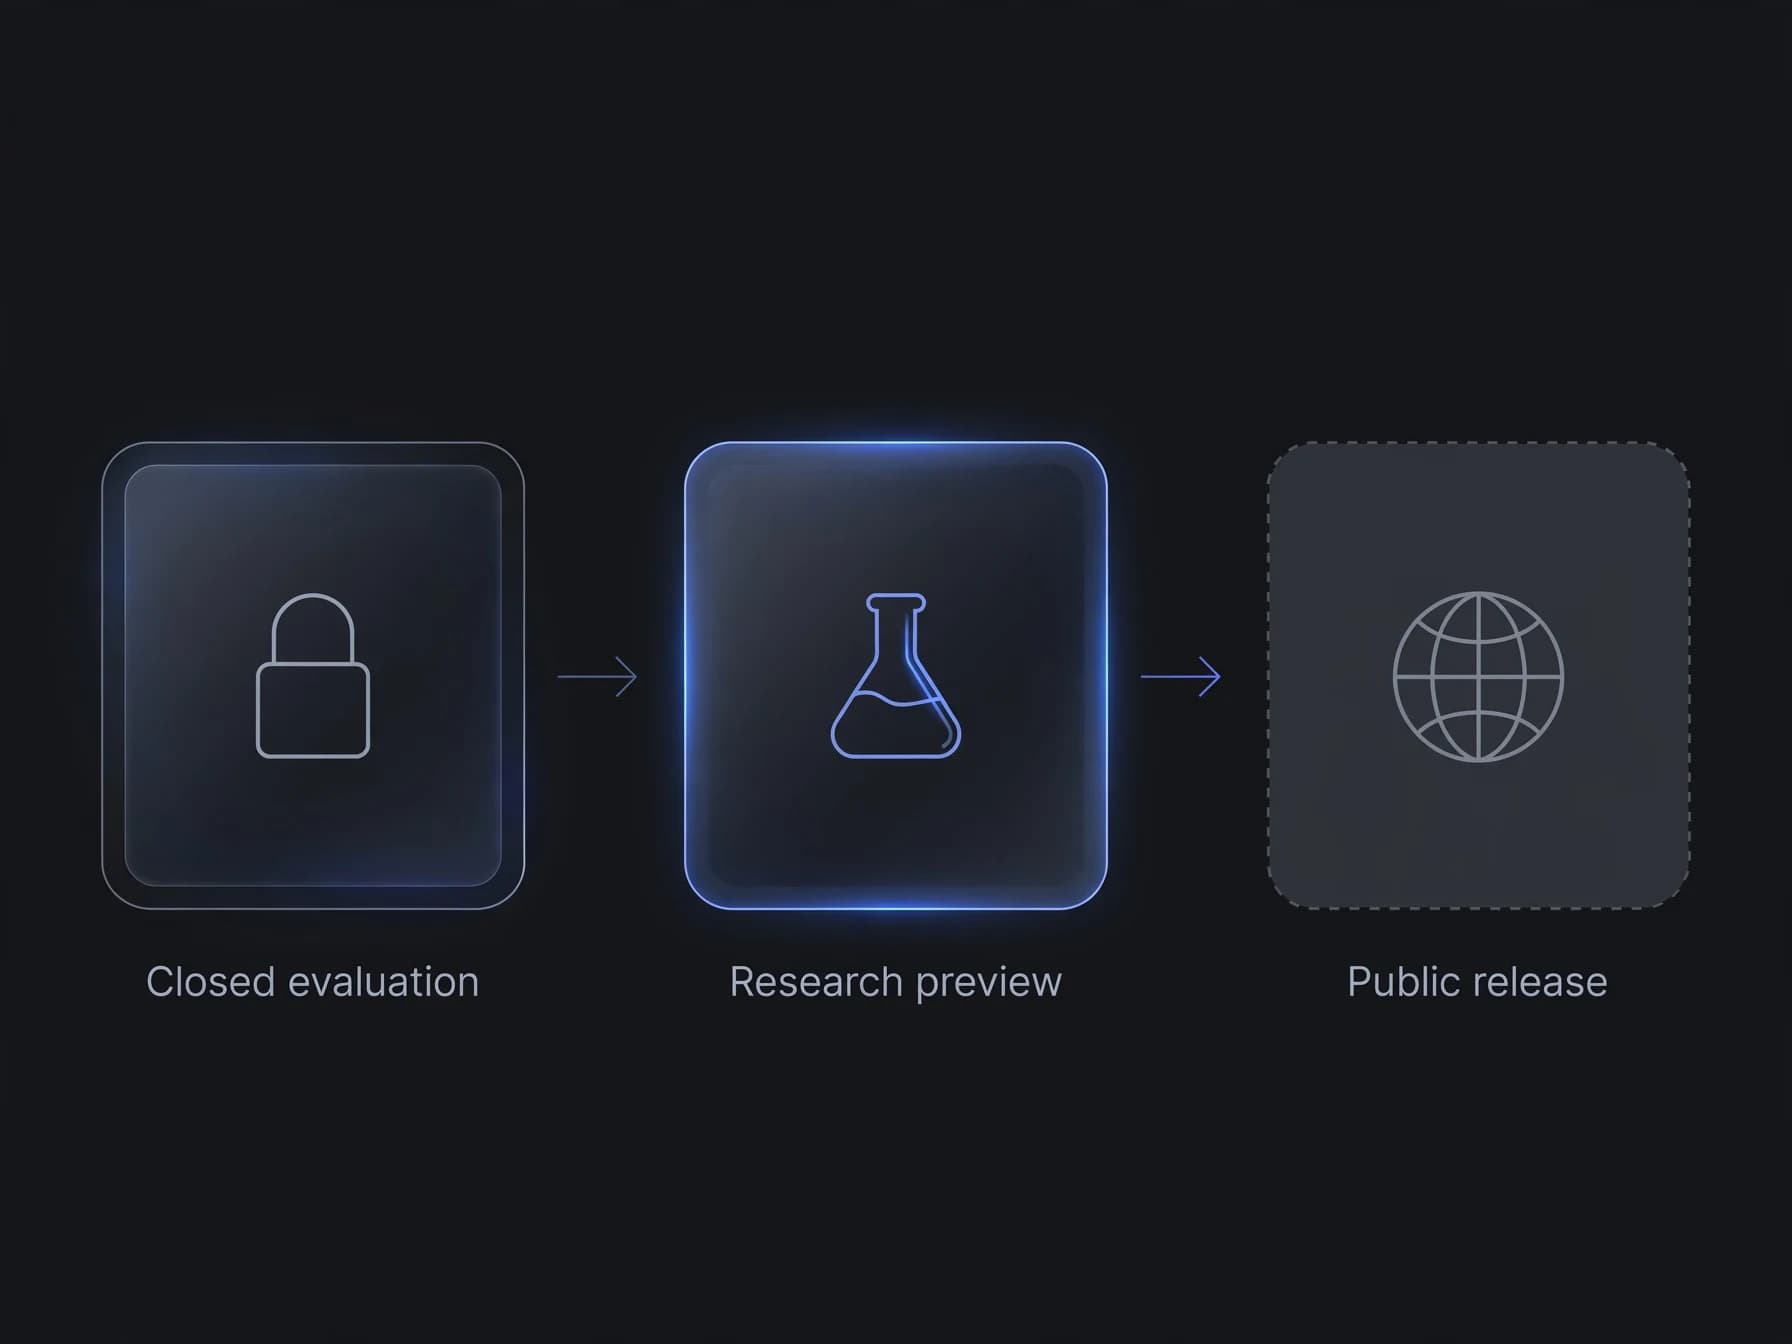
لا يزال الوصول إلى نظام الذكاء الاصطناعي Tavus Griffin الكامل محدودًا، حيث تجري الشركة تقييمات مغلقة. يتوفر حاليًا إصدار Griffin-Lite فقط كمعاينة بحثية لمختبري التطوير المحددين، ولم يُعلن بعد عن الأسعار الرسمية للنظام.
تعتمد خطط منصة Tavus الحالية على باقات استخدام شهرية تشمل: باقة مجانية توفر 20 دقيقة شهريًا من الفيديو التفاعلي، وباقة المبتدئين بسعر 22 دولارًا شهريًا، وباقة البناء بسعر 59 دولارًا شهريًا، وباقة النمو بسعر 397 دولارًا شهريًا، وباقة الأعمال بسعر 975 دولارًا شهريًا.
يمكن للمطورين الذين يستخدمون ميزات المنصة تدريب شخصيات بصرية مخصصة عبر فيديو تدريبي قصير أو صورة شخصية واحدة. كما تفرض المنصة معايير أمان صارمة لمنع نسخ الملامح غير المصرح به وسوء الاستخدام أثناء الجلسات المباشرة.
مراحل توفر الخدمة: تقييم مغلق، ومعاينة بحثية، وإطلاق رسمي لم يتم بعد
أدوات الفيديو المسجل مسبقًا مقابل شخصيات Tavus Griffin المباشرة
لفهم مجالات استخدام النماذج التفاعلية، يجب التفريق بين التفاعل المباشر وصناعة الفيديو التقليدية؛ فالشخصيات التفاعلية تركز على الردود الفورية في أقل من 200 مللي ثانية، مقابل التخلي عن التحكم السينمائي بالكاميرا وتوجيه الأوامر المعقدة.
في المقابل، تركز أدوات توليد الفيديو المسجل مسبقًا على أدق التفاصيل البصرية، والمؤثرات الصوتية، والأسلوب الفني. تتيح لك منصات مثل OnVid توليد مقاطع فيديو تصل إلى 60 ثانية في باقة Max من خلال الأوامر النصية أو الصور الثابتة، مما يمنحك تحكمًا كاملًا في وتيرة المشاهد وتكوينها.
ومع أن شخصيات الذكاء الاصطناعي التفاعلية قيد التطوير ضمن خطتنا في OnVid، يظل إنتاج الفيديو المسجل مسبقًا هو الخيار الأنسب للمقاطع التسويقية، ومحتوى التواصل الاجتماعي، والقصص المصورة. يساعدك الاطلاع على بدائل لـ Tavus ومقارنة بدائل لـ HeyGen في تحديد ما إذا كان مشروعك يحتاج إلى محادثة تفاعلية مباشرة أم إلى إنتاج فيديو بسيناريو محدد.
يبدأ تبني تقنيات مثل Tavus Griffin بتحديد الدور المطلوب من شخصيتك الآلية بدقة. يُعد الفيديو التفاعلي مثاليًا لخدمة العملاء، والتدريب على المحاكاة ولعب الأدوار، والمساعدة الافتراضية المباشرة حيث يكون التواصل ثنائي الاتجاه أمرًا ضروريًا.
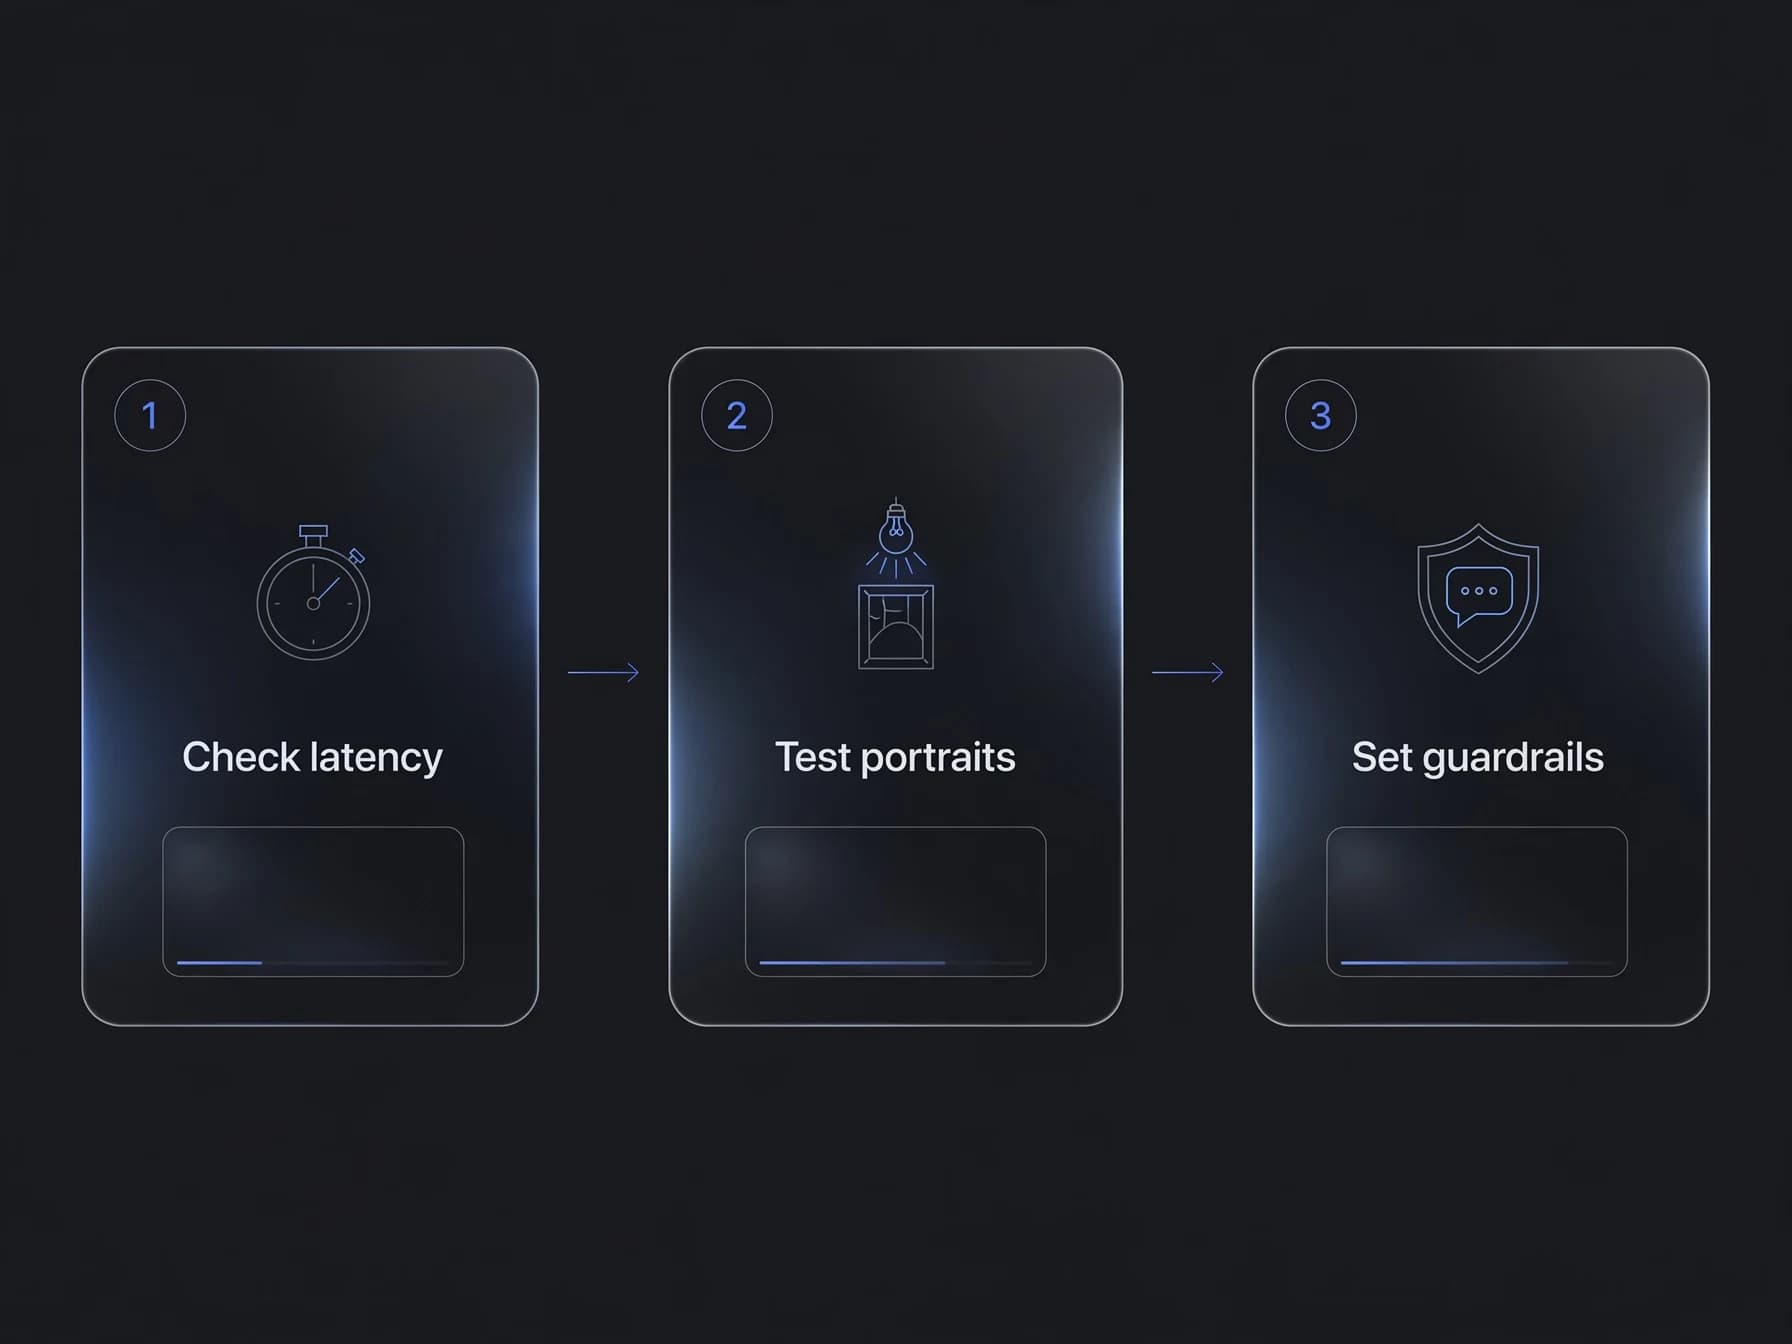
تتمثل الخطوة الأولى في فحص متطلبات زمن الاستجابة لمعرفة ما إذا كان البث المباشر أو الفيديو المُعد مسبقًا هو الأنسب لأهدافك. وتتضمن الخطوة الثانية اختبار صور شخصية بإضاءة واضحة، حتى تحافظ نماذج المعالجة على ثبات ملامح الوجه أثناء التحدث.
أما الخطوة الثالثة فهي وضع ضوابط واضحة للمحادثة تضمن بقاء الشخصيات الافتراضية ضمن سياقها الصحيح أثناء التفاعل المباشر. يساعد تجهيز هذه المتطلبات اليوم فريقك على الاستفادة من منصات الفيديو التفاعلي فور إتاحتها للجميع.
ثلاث خطوات للتحضير لفيديو الذكاء الاصطناعي المباشر: فحص زمن الاستجابة، واختبار الصور الشخصية، وتحديد ضوابط المحادثة
أهم النقاط حول Tavus Griffin بالعربية
يوضح Tavus Griffin مدى سرعة النماذج التفاعلية في تضييق فجوة الواقعية البصرية، ما يجعل وكلاء الذكاء الاصطناعي التفاعليين أقرب إلى التواصل البشري الطبيعي.
ورغم أن المعايير البحثية تبرز سرعات استجابة ودرجات إدراك مذهلة، لا يزال صانعو المحتوى بحاجة إلى الموازنة بين الحوار التفاعلي الحي والتحكم البصري الدقيق. يساعدك تتبع هذه التطورات على اختيار الأدوات المناسبة مع استمرار تطور التفاعل في الوقت الفعلي وفيديوهات الذكاء الاصطناعي المُعدة مسبقًا.
أسئلة شائعة حول Tavus Griffin
احصل على إجابات واضحة حول المعايير التقنية، وتفاصيل البنية البرمجية، وحدود المعاينة البحثية لنموذج Tavus Griffin ووكلاء المحادثة في الوقت الفعلي.
ما هو Tavus Griffin؟
Tavus Griffin هو بنية نموذج ذكاء اصطناعي طُوّرت لوكلاء الفيديو التفاعليين في الوقت الفعلي. أُعلن عن نموذج Tavus Griffin في 1 أكتوبر 2026، وهو مصمم لإجراء تفاعلات بصرية ثنائية الاتجاه بزمن انتقال منخفض وتوقيت محادثة يشبه الإنسان. ويمثل نقلة نوعية من التوليد التقليدي المعتمد على تبادل الأدوار إلى التفاعل الفوري المستمر.
هل اجتاز Tavus Griffin اختبار تورنغ للفيديو المباشر؟
في دراسة مكفوفة عبر مكالمة فيديو حية لمدة دقيقة واحدة شملت 54 شخصًا، اعتقد 48% من المشاركين أن Tavus Griffin كان إنسانًا حقيقيًا. ويمثل هذا تحسنًا لافتًا مقارنة بالنتيجة السابقة لنظام Tavus التي بلغت 2.4% (مقيّم واحد من أصل 41). ورغم أنه لم ينجح في إقناع جميع المقيّمين بالكامل، إلا أنه أول نظام منشور يسجل نسبة تقارب النصف في اختبار تورنغ البصري المباشر.
كيف كان أداء Tavus في اختبار NVIDIA VideoFDB القياسي؟
حقق النموذج المركز الأول في تقييم NVIDIA VideoFDB المخصص لأنظمة الفيديو التفاعلية. ونال 3.83 نقطة في جودة التوليد البصري مقارنة بـ 3.92 للمعدل البشري، و3.73 نقطة في الإدراك مقارنة بـ 4.20 للبشر. تقيس هذه المعايير مدى واقعية تعبيرات الوجه، واتجاه النظرات، وردود الفعل أثناء الاستماع والحوار.
ما هو فيديو الذكاء الاصطناعي مزدوج الاتجاه (Full Duplex) في وكلاء الحوار؟
يشير فيديو الذكاء الاصطناعي مزدوج الاتجاه إلى بث تفاعلي متواصل يسمح للإنسان والذكاء الاصطناعي بالتحدث والاستماع والمقاطعة في أي لحظة. فبدلًا من الانتظار حتى ينتهي الطرف الآخر من كلامه لمعالجة الرد، يحلل النظام الصوت الوارد بينما يُنشئ إطارات الفيديو في الوقت نفسه. وتتيح هذه التقنية إيماءات تفاعلية طبيعية مثل هز الرأس والموافقات الصوتية السريعة.
كيف تبني منصة Tavus الذكاء الاصطناعي حزمة الوكلاء الخاصة بها؟
تدمج منصة Tavus الذكاء الاصطناعي عدة نماذج متخصصة داخل وكلاء محادثة يُطلق عليهم اسم PALs. يستخدم المسار القياسي نموذج Sparrow-2 لإدارة تبادل الأدوار، وPhoenix-4.5 لتوليد الفيديو بزمن انتقال يقارب 134 ميلي ثانية، وRaven-1 للإدراك الحسي. أما نموذج Griffin الأحدث، فيجمع بين الإدراك والتوليد البصري في نظام محادثة موحد.
ما الفرق بين أداة مثل OnVid ونموذج Tavus Griffin؟
بخلاف Tavus Griffin، تركز OnVid على إنشاء فيديوهات جاهزة للتنزيل من نصوص أو صور بدلًا من المكالمات الحية، باستخدام نماذج مثل Seedance 2.5.
هل يمكن لأداة OnVid إنشاء فيديوهات لمتحدثين اليوم؟
نعم. تنشئ OnVid مقاطع لمتحدثين مسجلة مسبقًا مع مزامنة الشفاه من صورة شخصية واحدة، عبر نماذج تجسيد مثل OmniHuman وKling الذكاء الاصطناعي Avatar v2 في صفحة أداة تحريك الصور.
ما النماذج التي تشغل تحويل النص إلى فيديو في OnVid؟
تتيح OnVid نماذج رائدة مثل Seedance 2.5 وKling 2.5 Turbo وVeo 3.1، مع احتساب الرصيد بالثانية واسترداد تلقائي لأي مهمة لم تكتمل.
هل Tavus Griffin متاح للاستخدام العام حاليًا؟
وفرت شركة Tavus نموذج Griffin-Lite حصريًا كمعاينة بحثية مغلقة لعدد محدد من المختبرين والشركاء. ولا تتوفر البنية الكاملة بعد عبر أداة PAL Maker ذاتية الخدمة أو واجهات برمجة التطبيقات العامة، كما لم تُعلن تفاصيل الأسعار الرسمية أو موعد الإطلاق العام حتى الآن.
كم تبلغ تكلفة Tavus لوكلاء الفيديو التفاعليين العاديين؟
توفّر Tavus خططًا تتراوح بين باقة أساسية وخيارات مخصصة للشركات. ارجع إلى دليلنا المخصص لمعرفة التفاصيل الكاملة للباقات وحدود الاستخدام.
كم تبلغ تكلفة OnVid لإنشاء فيديوهات بالذكاء الاصطناعي؟
يتيح لك التسجيل استكشاف المنصة قبل اختيار اشتراك مدفوع. تتوفر باقة Pro بسعر 7.99 دولار أسبوعيًا أو 14.99 دولار شهريًا، بينما تبلغ تكلفة باقة Max 14.99 دولار أسبوعيًا أو 28.99 دولار شهريًا. توفر كِلتا الباقتين المدفوعتين تنزيلات بدقة HD بدون علامة مائية، مع حساب استهلاك الرصيد بناءً على النموذج ومدة الفيديو.
هل يمكنك استخدام الفيديوهات المنشأة بالذكاء الاصطناعي في مشاريع تجارية؟
يعتمد الاستخدام التجاري على النموذج المستخدم لإنشاء الفيديو؛ تحقّق من شروط خدمة OnVid وشروط النموذج المحدّد قبل البدء في استخدامه تجاريًا.
هل يمكن لـ Tavus إنشاء شخصيات افتراضية مخصصة من صورة واحدة؟
تدعم Tavus تدريب نُسخ رقمية مخصصة سواء من صورة واحدة أو مقطع فيديو مرجعي قصير. بمجرد المعالجة، يمكن تشغيل الوجه المخصص داخل وكلاء PAL التفاعليين لإجراء محادثات آلية مع المستخدمين. بالنسبة للمحتوى المُعد مسبقًا، تعمل أدوات مثل OnVid على تحريك صور البورتريه الفردية لتحويلها إلى فيديوهات متحدثة باستخدام نماذج مزامنة حركة الشفاه.
أين يمكن لصُنّاع المحتوى العثور على بدائل لـ Tavus لإنتاج الفيديو؟
يمكنك قراءة مراجعتنا التفصيلية حول بدائل لـ Tavus للمقارنة بين الوكلاء التفاعليين الفوريين وأدوات التوليد غير المتزامنة. المشروعات التي تحتاج إلى مقاطع تسويقية جاهزة أو فيديوهات سردية أو منشورات لمنصات التواصل تستفيد عمومًا من أدوات نص إلى فيديو وصورة إلى فيديو. ويعتمد الخيار الأفضل على ما إذا كان استخدامك يتطلب مكالمات فيديو مباشرة أو ملفات فيديو قابلة للتنزيل.
ما الذي يقيسه اختبار تورنغ للفيديو في الذكاء الاصطناعي؟
يقيم اختبار تورنغ للفيديو ما إذا كان بإمكان المشاركين البشريين التمييز بين شخصية افتراضية بالذكاء الاصطناعي في بث فيديو مباشر وإنسان حقيقي. يشارك الحضور عادةً في محادثة قصيرة لتقييم التماسك البصري، وتعبيرات الوجه الدقيقة، ومعدل تأخر الاستجابة. يتطلب النجاح القضاء على بطء الاستجابة، وحركات الشفاه غير الطبيعية، والوقفات المصطنعة.
كيف تتعامل نماذج الفيديو التفاعلية مع مقاطعة الحديث؟
تستخدم الأنظمة التفاعلية الحديثة نماذج إدراك صوتي مدمجة لاكتشاف كلام البشر أثناء حديث الشخصية الافتراضية. عندما يتحدث المستخدم، يوقف النظام معالجة الفيديو فورًا وتعود الشخصية إلى وضع الاستماع والانتباه. تمنع هذه الاستجابة السريعة الشخصية من مواصلة الكلام فوق صوت المستخدم، مما يحافظ على سلاسة الحوار وطبيعيته.