12 de noviembre de 2026
9 min de lectura
Industry Insights

Tavus Griffin: la primera IA en pasar el test de Turing en vídeo

Tavus Griffin es un modelo interactivo de vídeo con IA conversacional diseñado para videollamadas en tiempo real con turnos de palabra naturales, movimiento facial fluido y respuestas de voz en menos de un segundo. En pruebas a ciegas recientes, el 48 % de los participantes creyó que el avatar digital era una persona real tras sesenta segundos de charla.

Por Revisado por Jonah WellerCómo revisamos

¿Qué es Tavus Griffin y cómo funciona?

Tavus Griffin marca un punto de inflexión en los medios sintéticos al medirse en un test de Turing de vídeo en directo pensado para evaluar el realismo conversacional. Desarrollado por Tavus, Griffin es una arquitectura avanzada de modelos conversacionales creada para dar vida a personajes digitales que hablan, escuchan y reaccionan en videollamadas bidireccionales.

Los modelos de vídeo tradicionales generan vídeos de forma secuencial a partir de indicaciones de texto o fotos fijas. Griffin funciona de otro modo: emite en directo movimientos faciales fluidos, diálogos hablados y reacciones sutiles al mismo tiempo que procesa el audio de quien habla en vivo.

Presentada el 1 de octubre de 2026, esta tecnología busca acortar distancias entre el metraje sintético pregrabado y las interacciones en vídeo en tiempo real. Modela microexpresiones faciales y un ritmo vocal muy preciso para que los presentadores digitales mantengan conversaciones en vídeo prolongadas con un compás natural.

Tavus Griffin frente a humanos: resultados en las pruebas de referencia

Durante una rigurosa evaluación con un test de Turing para IA, los investigadores comprobaron si observadores corrientes podían diferenciar un sistema automatizado de una persona real en tiempo real. En una videollamada en directo de un minuto con 54 participantes humanos, el 48 % creyó que hablaba con una persona de verdad. En cambio, la versión anterior de Tavus solo convenció al 2,4 % de los participantes (uno de cada 41 evaluadores).

El sistema también se colocó en el primer puesto del banco de pruebas conversacional NVIDIA VideoFDB. Logró una puntuación de realismo visual de 3,83 (frente al 3,92 de los vídeos humanos) y una calificación de percepción de 3,73 (frente al 4,20 del comportamiento humano).

Estos datos muestran que la generación de vídeo en tiempo real roza la paridad perceptiva en charlas breves. Aunque en conversaciones más largas aún se aprecian artefactos sintéticos, los intercambios cortos ya reproducen una presencia humana creíble de manera demostrable.
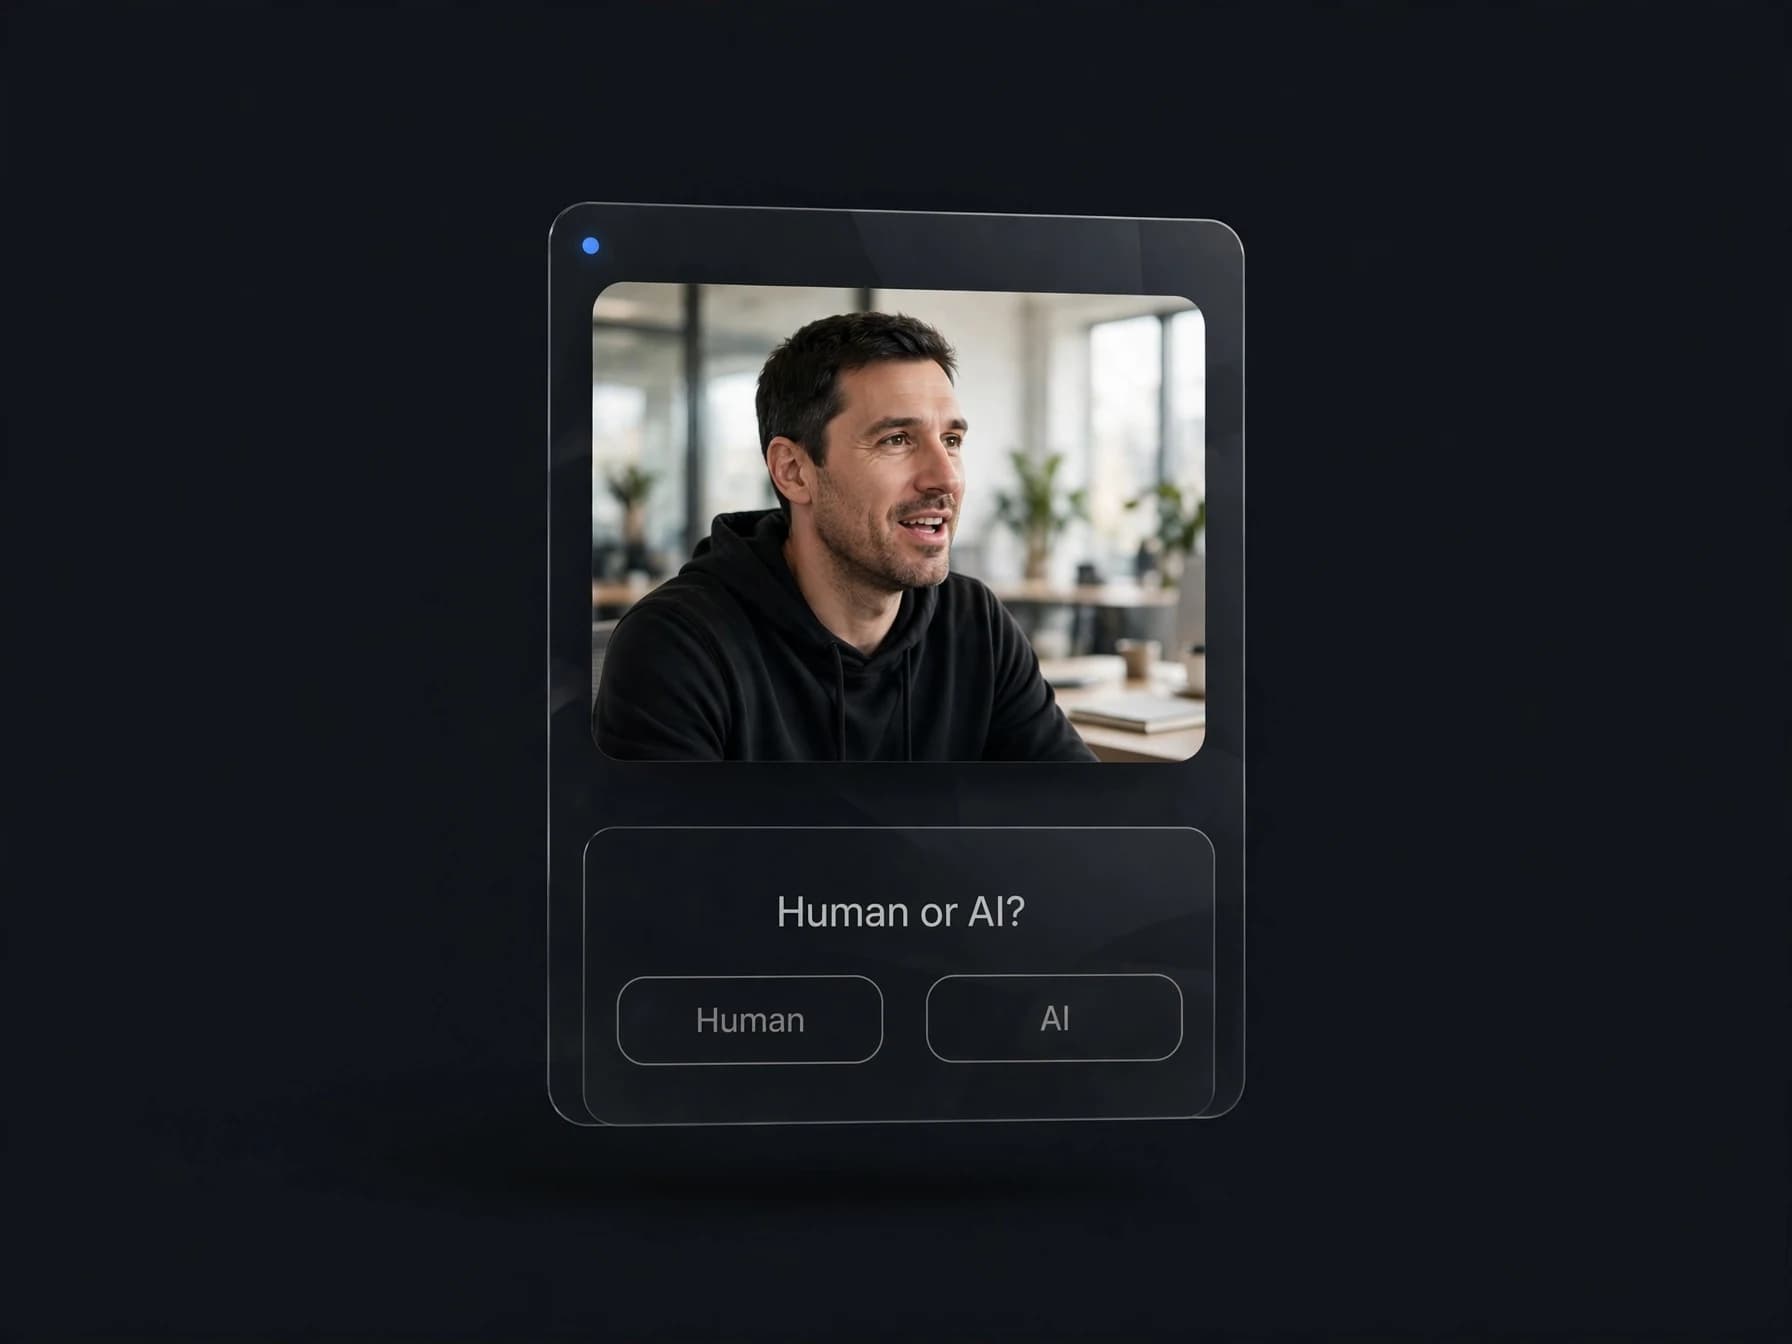
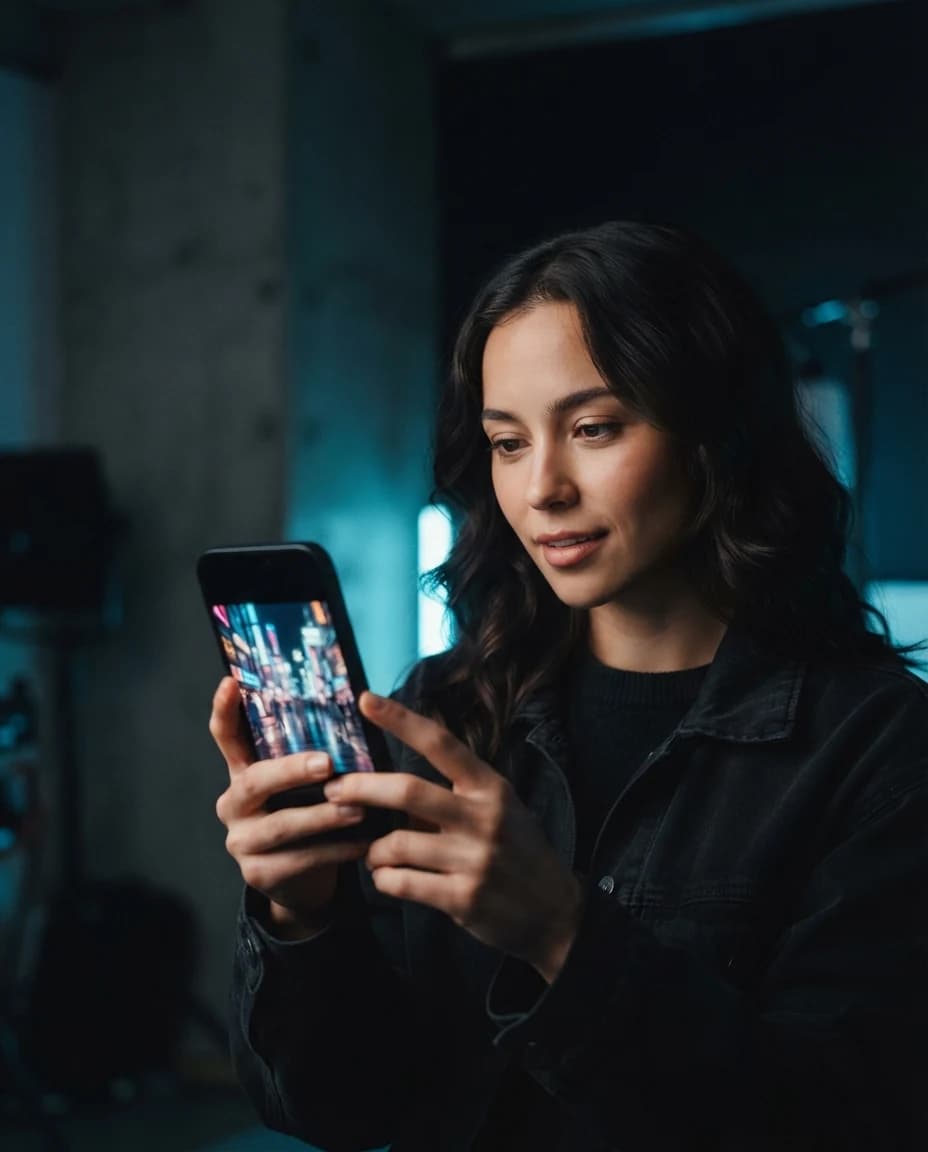
Videollamada en directo con una tarjeta de encuesta que pregunta si quien habla es humano o una IA

Tavus Griffin y la arquitectura de transmisión en agentes de vídeo con IA

Poner en marcha un avatar de IA en tiempo real exige sincronizar la generación de fotogramas visuales con los matices inmediatos de la conversación. Tavus organiza esta experiencia con sistemas especializados que se reparten la comprensión, el ritmo verbal y el vídeo resultante.

El flujo de trabajo utiliza Raven-1 para la percepción sensorial y Sparrow-2 para los turnos de conversación y la gestión de interrupciones. La renderización corre a cargo de Phoenix-4.5 con una latencia muy baja, en torno a 134 milisegundos, mientras que Griffin aporta un modelado facial detallado y una adaptación continua al entorno.

Gracias a esta arquitectura, los desarrolladores pueden crear agentes conversacionales que callan cuando los interrumpes y retoman la palabra de forma natural. Mientras que herramientas para creadores como un generador de avatares con IA producen vídeos pregrabados de gran calidad a partir de fotos, las arquitecturas conversacionales se centran de lleno en la transmisión de baja latencia.

Cómo acceder a Tavus Griffin y disponibilidad actual

El acceso al sistema completo de IA Tavus Griffin sigue siendo limitado mientras la empresa realiza evaluaciones cerradas. Actualmente, solo Griffin-Lite está disponible como versión preliminar de investigación para desarrolladores seleccionados, y aún no se han anunciado los precios oficiales para esta arquitectura.

Los planes generales de la plataforma Tavus se organizan en niveles de uso mensual. Incluyen un plan Gratis con 20 minutos de vídeo conversacional al mes, un plan Starter por 22 $ al mes, un nivel Builder por 59 $ al mes, un nivel Growth por 397 $ al mes y un plan Business por 975 $ al mes.

Los desarrolladores que utilizan las funciones actuales pueden entrenar avatares visuales personalizados mediante un vídeo breve o un único retrato de referencia. La plataforma incluye controles estrictos de seguridad para evitar la clonación no autorizada de rostros y el uso indebido en sesiones en directo.
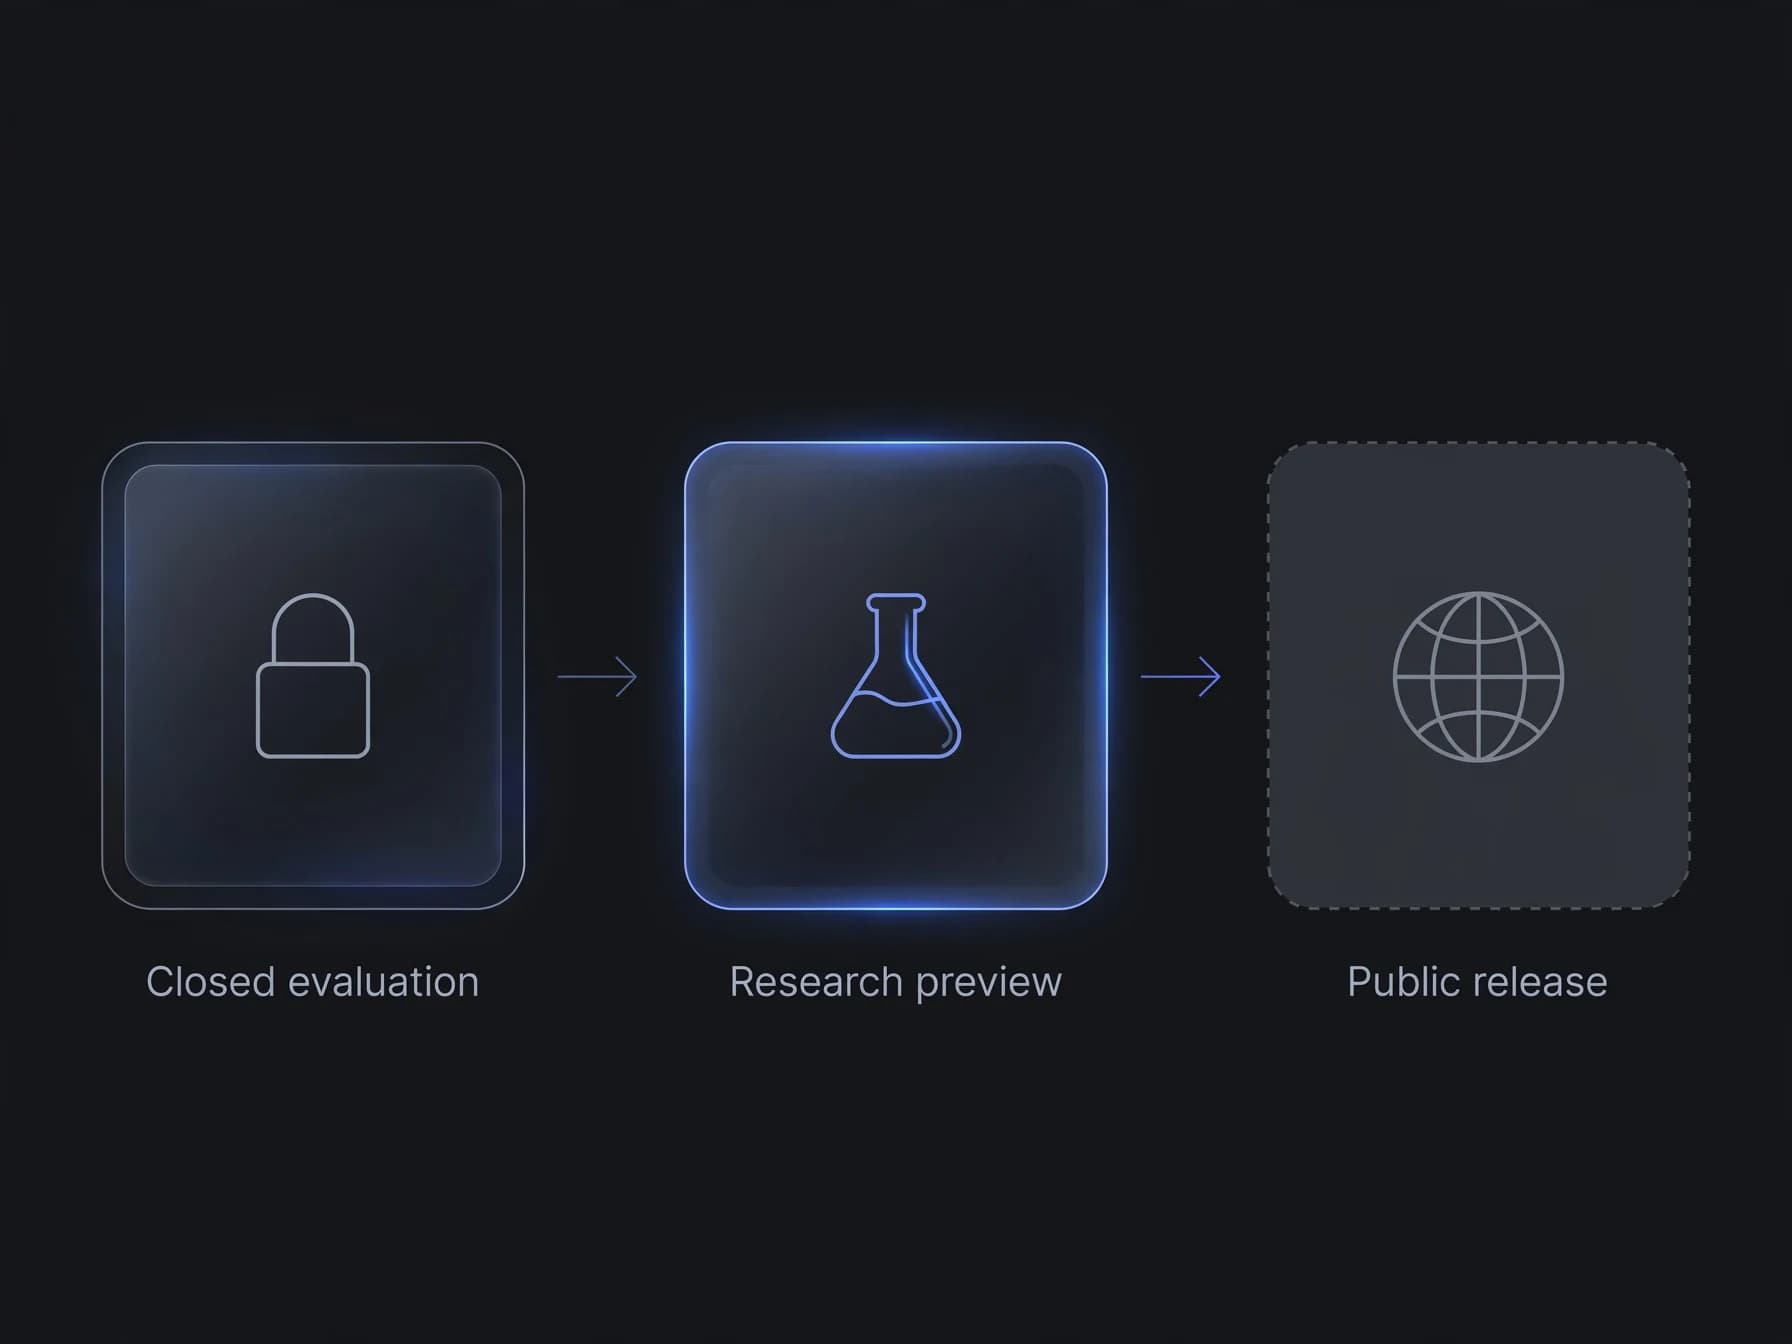
Cronograma de acceso: evaluación cerrada, versión preliminar para investigación y lanzamiento público aún pendiente

Herramientas de vídeo con IA pregrabado frente a agentes conversacionales en directo

Para entender el lugar de los modelos conversacionales, conviene diferenciar la interacción en tiempo real de la creación de vídeo tradicional. Los agentes en directo priorizan respuestas rápidas en menos de 200 milisegundos, sacrificando el control de cámara cinematográfico y la dirección detallada mediante prompts.

Por contra, los generadores de vídeo pregrabado se centran en ofrecer el máximo detalle visual, efectos de sonido y control de estilo. Plataformas como OnVid te permiten generar vídeos de hasta 60 segundos en los planes Max a partir de texto o fotos fijas, dándote control directo sobre el ritmo y la composición de cada escena.

Aunque los avatares interactivos con IA en tiempo real forman parte de nuestra hoja de ruta en OnVid, la producción de vídeo pregrabado sigue siendo la opción práctica para clips de marketing, redes sociales y narrativa visual. Explorar alternativas a Tavus y comparar alternativas a HeyGen populares te ayudará a decidir si tu proyecto requiere un diálogo en directo con usuarios o una producción de vídeo planificada.

Tavus Griffin en tu flujo de trabajo: cómo prepararlo

Adoptar tecnologías como un flujo de trabajo de vídeo con Tavus Griffin empieza por definir el papel de tu agente automatizado. El vídeo interactivo destaca en atención al cliente, simulaciones de formación y asistencia virtual en tiempo real donde la respuesta bidireccional es clave.

El paso 1 consiste en analizar tus requisitos de latencia para ver si tu proyecto se adapta mejor a la transmisión en directo o al vídeo renderizado previamente. El paso 2 requiere probar imágenes de retratos con buena iluminación, de modo que los modelos de avatares mantengan los rasgos faciales estables mientras hablan.

El paso 3 implica fijar límites conversacionales claros para que los avatares sintéticos no se desvíen en sus interacciones con usuarios reales. Preparar estos elementos hoy garantiza que tu equipo esté listo cuando las plataformas de vídeo conversacional estén al alcance de todos.
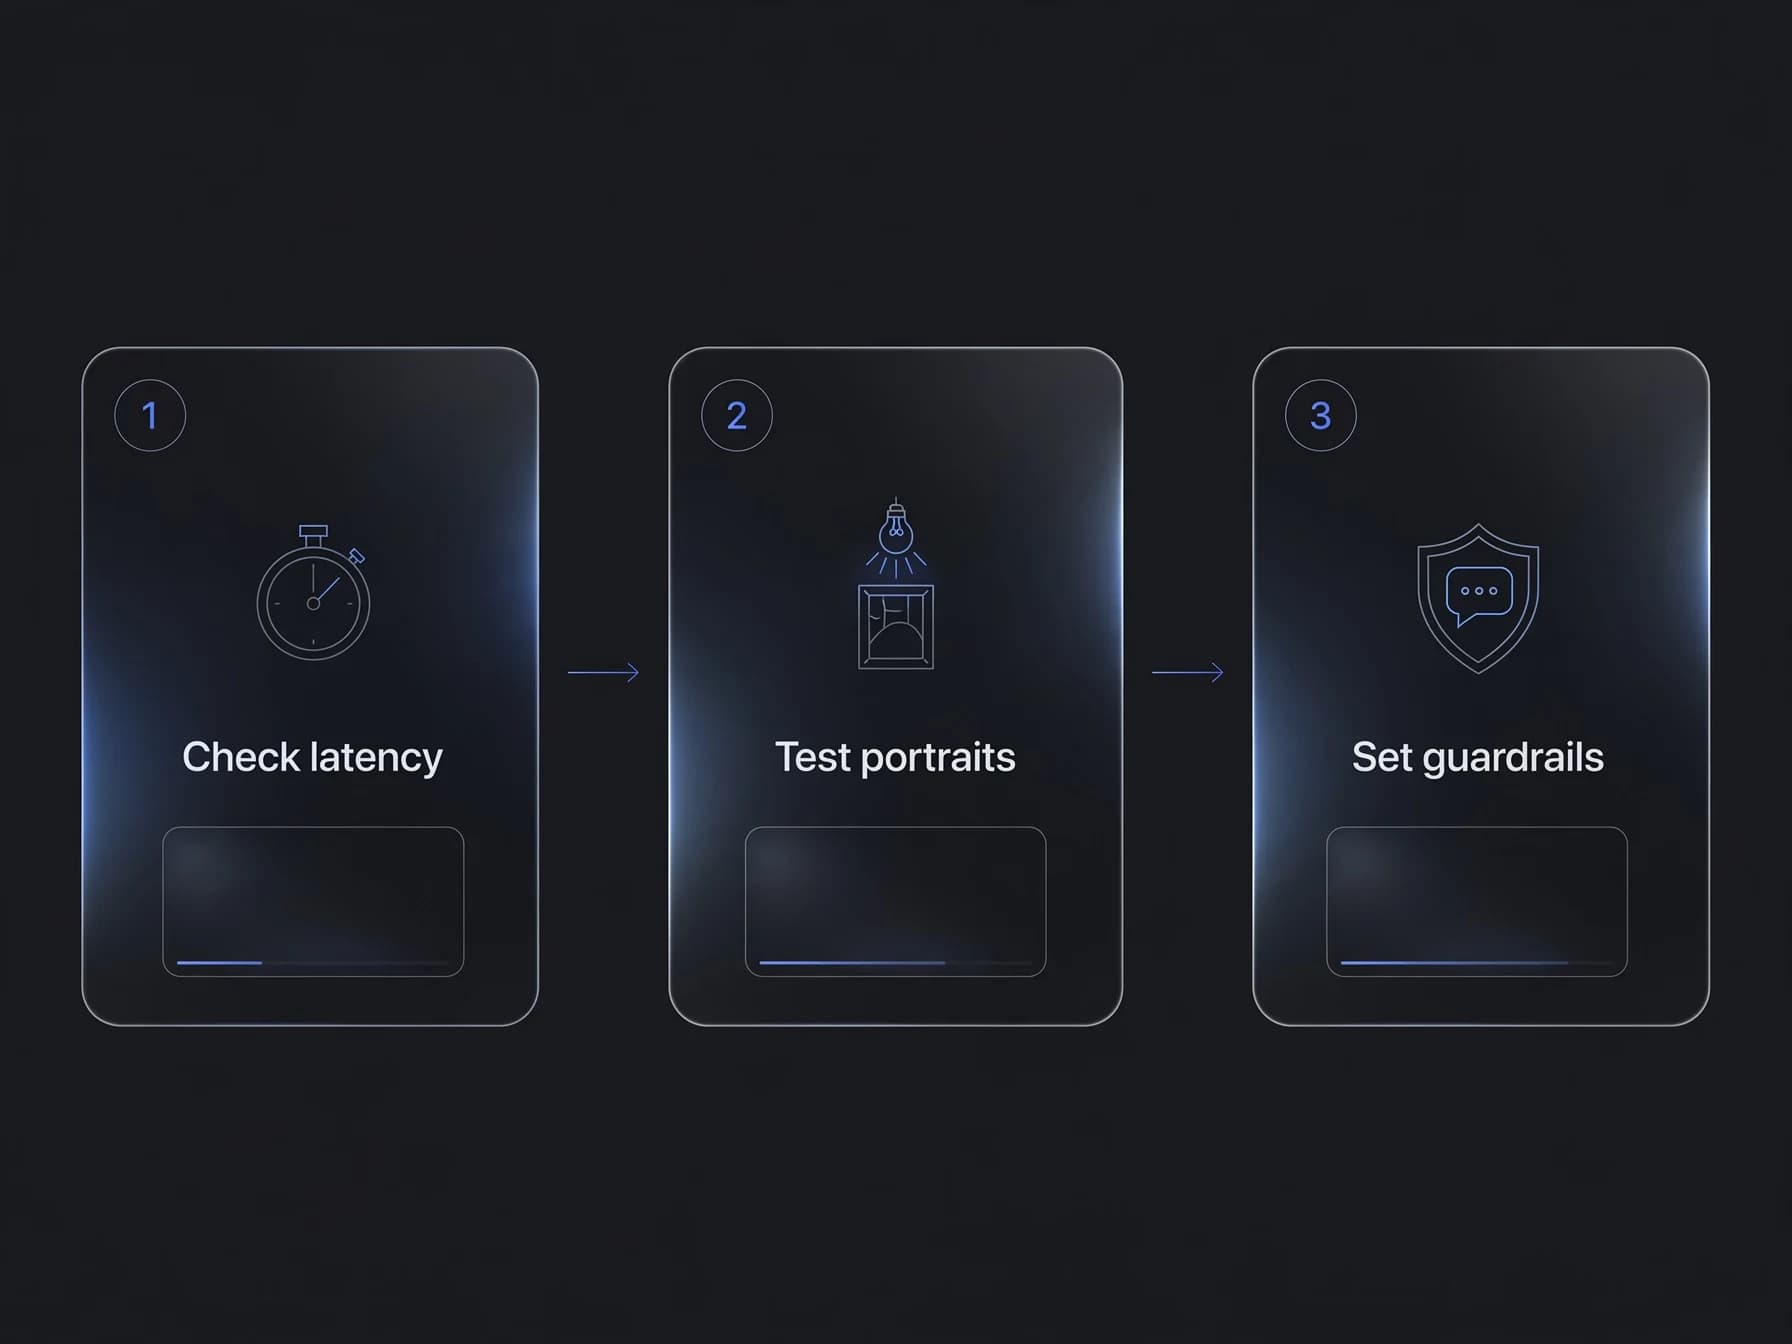
Tres pasos para preparar vídeo con IA en directo: comprobar latencia, probar retratos y fijar límites conversacionales

Puntos clave sobre Tavus Griffin en español

Tavus Griffin demuestra la rapidez con la que los modelos conversacionales reducen la brecha del realismo visual, acercando los agentes interactivos de IA a una interacción humana natural.

Aunque las pruebas de investigación muestran velocidades de respuesta y puntuaciones de percepción impresionantes, los creadores aún deben sopesar la fluidez conversacional frente al control visual exacto. Seguir estos hitos te ayuda a elegir las herramientas adecuadas mientras la interacción en tiempo real y los vídeos con IA prerrenderizados siguen evolucionando.

Preguntas frecuentes sobre Tavus Griffin

Encuentra respuestas claras sobre las métricas técnicas, la arquitectura y los límites de la versión de prueba de Tavus Griffin y los agentes conversacionales en tiempo real.

¿Qué es Tavus Griffin?

Tavus Griffin es una arquitectura de modelos de IA desarrollada para agentes de vídeo conversacional en tiempo real. Presentado el 1 de octubre de 2026, el modelo Tavus Griffin está diseñado para mantener interacciones visuales bidireccionales con baja latencia y un ritmo conversacional similar al humano. Supone un salto desde el renderizado por turnos tradicional hacia una interacción continua y reactiva.

¿Pasó Tavus Griffin el test de Turing en videollamada?

En un estudio a ciegas con videollamadas de un minuto y 54 participantes, el 48 % creyó que Tavus Griffin era una persona real. Esto supuso una mejora notable frente al resultado previo del sistema de Tavus, que logró un 2,4 % con 1 de 41 evaluadores. Aunque no engañó a todos los evaluadores, representa el primer sistema documentado en alcanzar casi un 50 % de probabilidades en una prueba visual de Turing en directo.

¿Cómo rindió Tavus en el banco de pruebas VideoFDB de NVIDIA?

La arquitectura logró el primer puesto en la prueba comparativa VideoFDB de NVIDIA que evalúa sistemas de vídeo conversacional. Obtuvo una puntuación de generación visual de 3,83 frente al 3,92 de referencia humana, y una puntuación de percepción de 3,73 frente al 4,20 humano. Estas métricas miden con qué naturalidad muestra el sistema las expresiones, la dirección de la mirada y las reacciones de escucha durante el diálogo.

¿Qué es el vídeo con IA full duplex en agentes conversacionales?

El vídeo con IA full duplex es una transmisión continua y bidireccional donde tanto el usuario como la IA pueden hablar, escuchar e interrumpir en cualquier momento. En vez de esperar a que termine un turno de palabra para calcular la respuesta, el sistema procesa el audio entrante mientras genera fotogramas de vídeo a la vez. Esto permite respuestas naturales de fondo, como asentir con la cabeza o dar confirmaciones verbales breves.

¿Cómo estructura Tavus IA su arquitectura de agentes?

La plataforma conocida como Tavus IA combina modelos especializados en agentes conversacionales llamados PAL. El flujo habitual utiliza Sparrow-2 para gestionar los turnos de conversación, Phoenix-4.5 para el renderizado de vídeo con unos 134 milisegundos de latencia, y Raven-1 para la percepción sensorial. El modelo más reciente, Griffin, unifica la percepción y la generación visual en un único sistema conversacional.

¿En qué se diferencia una herramienta como OnVid de Tavus Griffin?

A diferencia de Tavus Griffin, OnVid se centra en vídeos listos para descargar a partir de texto o fotos, usando modelos como Seedance 2.5 en vez de llamadas en directo.

¿Puede la herramienta de OnVid crear vídeos con presentadores parlantes?

Sí. OnVid crea vídeos con presentadores parlantes y sincronización labial desde una foto fija usando modelos como OmniHuman y Kling IA Avatar v2 en nuestro generador de fotos parlantes.

¿Qué modelos impulsan la generación de texto a vídeo en OnVid?

OnVid cuenta con opciones punteras como Seedance 2.5, Kling 2.5 Turbo y Veo 3.1. Los créditos se miden por segundo y las tareas fallidas se reembolsan automáticamente.

¿Está disponible Tavus Griffin de forma pública en este momento?

Tavus ha puesto a disposición Griffin-Lite únicamente como una versión de prueba cerrada para evaluadores y socios seleccionados. La arquitectura completa aún no está disponible en la herramienta de autoservicio PAL Maker ni en los planes de API públicos. Todavía no se han anunciado precios públicos oficiales ni fechas para su lanzamiento general.

¿Cuánto cuesta Tavus para agentes de vídeo conversacionales estándar?

Tavus ofrece planes desde un nivel básico hasta opciones empresariales a medida. Consulta nuestra guía para conocer todos los detalles sobre planes y límites de uso.

¿Cuánto cuesta OnVid para generar vídeos con IA?

Al registrarte puedes explorar la plataforma antes de elegir una suscripción de pago. Pro está disponible por 7,99 $ a la semana o 14,99 $ al mes, y Max por 14,99 $ a la semana o 28,99 $ al mes. Ambos planes de pago ofrecen descargas en HD sin marca de agua y descuentan créditos según el modelo y la duración del vídeo.

¿Puedes usar vídeos generados con IA en proyectos comerciales?

El uso comercial depende del modelo que creó el vídeo. Revisa los Términos de servicio de OnVid y las condiciones del modelo antes de usarlo comercialmente.

¿Puede Tavus crear avatares personalizados a partir de una sola foto?

Tavus permite entrenar réplicas digitales personalizadas a partir de una sola foto o de un breve vídeo de referencia. Tras procesarla, puedes usar esa cara personalizada en agentes conversacionales PAL para interactuar de forma automatizada. Si buscas contenido pregrabado, herramientas como OnVid animan fotos de retrato para crear vídeos que hablan mediante modelos de sincronización labial.

¿Dónde encontrar alternativas a Tavus para producción de vídeo?

Puedes leer nuestra comparativa de alternativas a Tavus para contrastar agentes conversacionales en tiempo real con herramientas de generación asíncrona. Si tu proyecto necesita vídeos de marketing acabados, piezas narrativas o publicaciones para redes, te convendrán más los generadores de texto a video e imagen a video. La mejor opción dependerá de si necesitas videollamadas en directo o archivos de vídeo descargables.

¿Qué mide un test de Turing de vídeo en inteligencia artificial?

Un test de Turing de vídeo evalúa si los participantes humanos pueden distinguir en una videollamada en directo entre un avatar de IA y una persona de carne y hueso. Los participantes suelen mantener una conversación breve para valorar la coherencia visual, las microexpresiones faciales y la latencia al hablar. Para superarlo, hay que eliminar los retardos, el movimiento labial poco natural y las pausas rígidas.

¿Cómo gestionan las interrupciones los modelos de vídeo conversacional?

Los sistemas conversacionales modernos emplean modelos de percepción de audio integrados que detectan la voz humana mientras el avatar habla. En cuanto hablas, el sistema detiene al instante la generación de vídeo y pone al avatar en actitud de escucha atenta. Esta respuesta rápida evita que el avatar te hable por encima y mantiene la interacción fluida.

Ver blogs similares

More from the blog

Explorar más