12 листопада 2026 р.
9 хв читання
Industry Insights

Tavus Griffin: перший ШІ, що пройшов відео тест Тюрінга

Tavus Griffin — це інтерактивна розмовна модель відео з ШІ для відеодзвінків у реальному часі. Вона забезпечує природне чергування реплік, плавні рухи обличчя та відповіді менш ніж за секунду. В нещодавніх сліпих тестах 48% учасників визнали цифрового аватара справжньою людиною після хвилинного спілкування.

Автор Перевірено Jonah WellerЯк ми перевіряємо

Що таке tavus griffin і як він працює?

Tavus Griffin став проривом у синтетичних медіа, взявши участь у відео тесті Тьюрінга наживо для оцінки реалістичності розмови. Створений компанією Tavus, Griffin — це сучасна розмовна модель, яка дає змогу цифровим персонажам розмовляти, слухати та реагувати під час двосторонніх відеодзвінків.

Звичайні моделі створюють відео послідовно за текстовими підказками або нерухомими фото. Griffin працює інакше: він передає плавні рухи обличчя, мовлення й природні реакції одночасно, паралельно аналізуючи голос співрозмовника наживо.

Цю технологію представили 1 жовтня 2026 року, і її мета — прибрати розрив між заздалегідь згенерованими синтетичними роликами та живим інтерактивним відео. Вона моделює мікровирази обличчя й природний темп мови, завдяки чому цифрові ведучі можуть спілкуватися невимушено та плавно.

Як тестували tavus griffin у порівнянні з реальними людьми

Під час суворого тесту Тьюрінга для ШІ дослідники перевіряли, чи зможуть звичайні спостерігачі в реальному часі відрізнити автоматизовану систему від живої людини. За підсумками однохвилинних відеодзвінків за участю 54 користувачів 48 відсотків вважали, що розмовляють зі справжньою людиною. Для порівняння, попередня версія Tavus змогла переконати лише 2,4 відсотка учасників (одного з 41 оцінювача).

Система також посіла перше місце в бенчмарку розмовних систем NVIDIA VideoFDB. Її реалістичність генерації склала 3,83 бала проти 3,92 у справжнього відео, а оцінка природності сприйняття — 3,73 проти 4,20 у людей.

Ці результати свідчать про те, що генерація відео в реальному часі вже майже зрівнялася з людиною в коротких діалогах. Хоча тривалі розмови все ще виявляють штучне походження персонажа, короткі бесіди вже вражають своєю правдоподібністю.
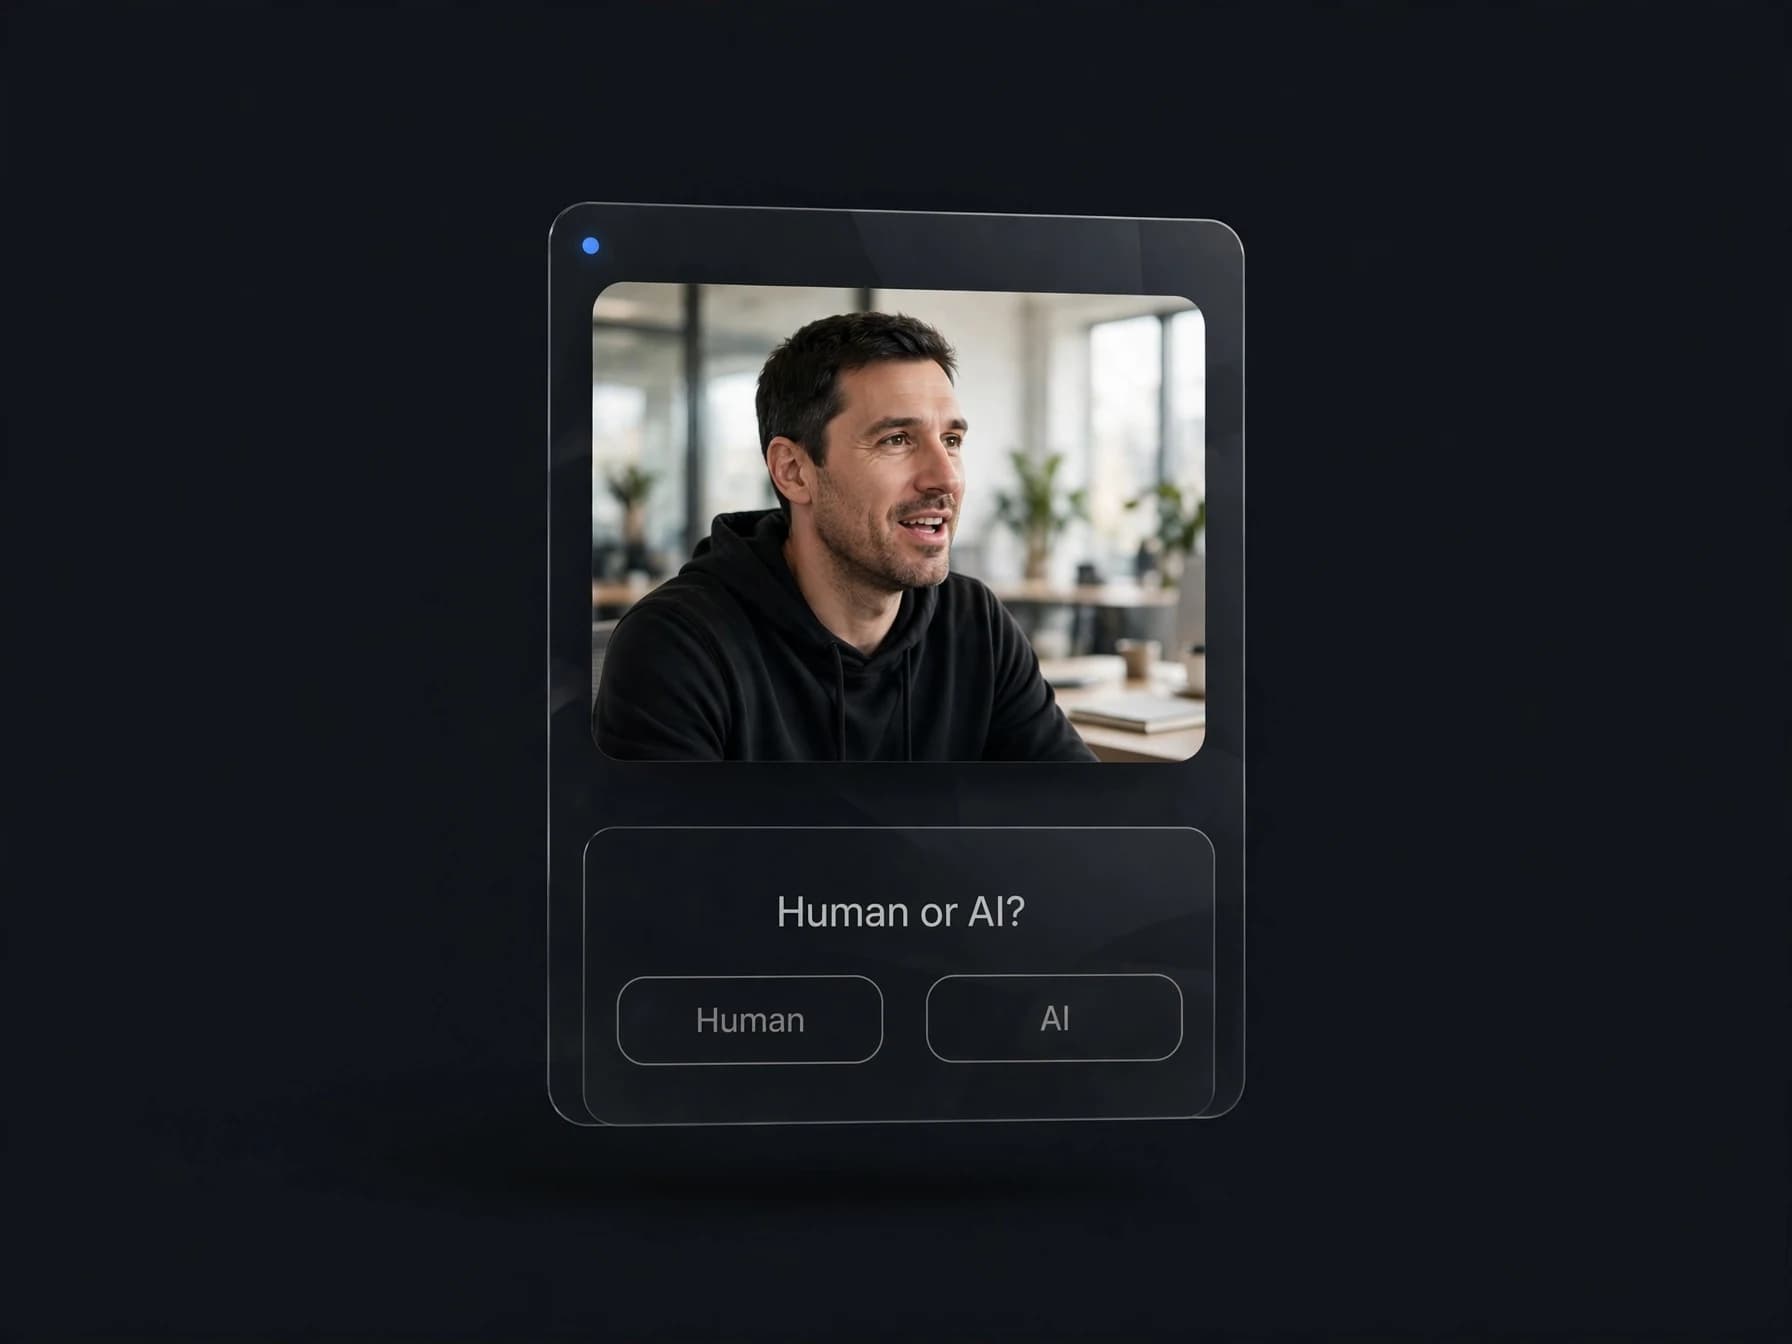
Відеодзвінок наживо з опитуванням на екрані, де запитують, хто перед глядачем: людина чи ШІ

Потокова архітектура розмовних агентів відео з ШІ

Для роботи інтерактивного ШІ-аватара в реальному часі потрібно синхронізувати генерацію кадрів із миттєвими реакціями в діалозі. Tavus досягає цього за допомогою спеціалізованих модулів, що відповідають за розуміння контексту, швидкість відповіді та генерацію зображення.

Система використовує модель Raven-1 для сприйняття мови, а Sparrow-2 — для чергування реплік і реагування на перебивання. Візуалізацією керує Phoenix-4.5 із низькою затримкою близько 134 мілісекунд, тоді як Griffin забезпечує високоточне моделювання міміки та плавну адаптацію до середовища.

Завдяки такій архітектурі розробники можуть створювати розмовних агентів, які зупиняються, якщо їх перебити, і плавно продовжують думку далі. Тоді як інструменти на кшталт генератора аватарів із ШІ створюють готові ролики з озвученими фото, потокові розмовні системи зосереджені саме на живому спілкуванні без затримок.

Доступ до Tavus Griffin та актуальні плани платформи

Повний доступ до системи ШІ Tavus Griffin наразі обмежений, оскільки компанія проводить закриті тестування. Лише версія Griffin-Lite доступна як попередня дослідницька версія для окремих розробників, а відкриті ціни для цієї архітектури ще не оголошені.

Загальні тарифи платформи Tavus, як і раніше, побудовані на щомісячних пакетах використання. Серед них є безкоштовний тариф із 20 хвилинами розмовного відео на місяць, план Starter за 22 $ на місяць, Builder за 59 $ на місяць, Growth за 397 $ на місяць і план Business за 975 $ на місяць.

Розробники з доступом до поточних функцій платформи можуть створювати власні цифрові персонажі за допомогою короткого навчального відео або одного фотопортрета. Платформа має суворі перевірки безпеки, які запобігають несанкціонованому копіюванню зовнішності та зловживанням під час живих сесій.
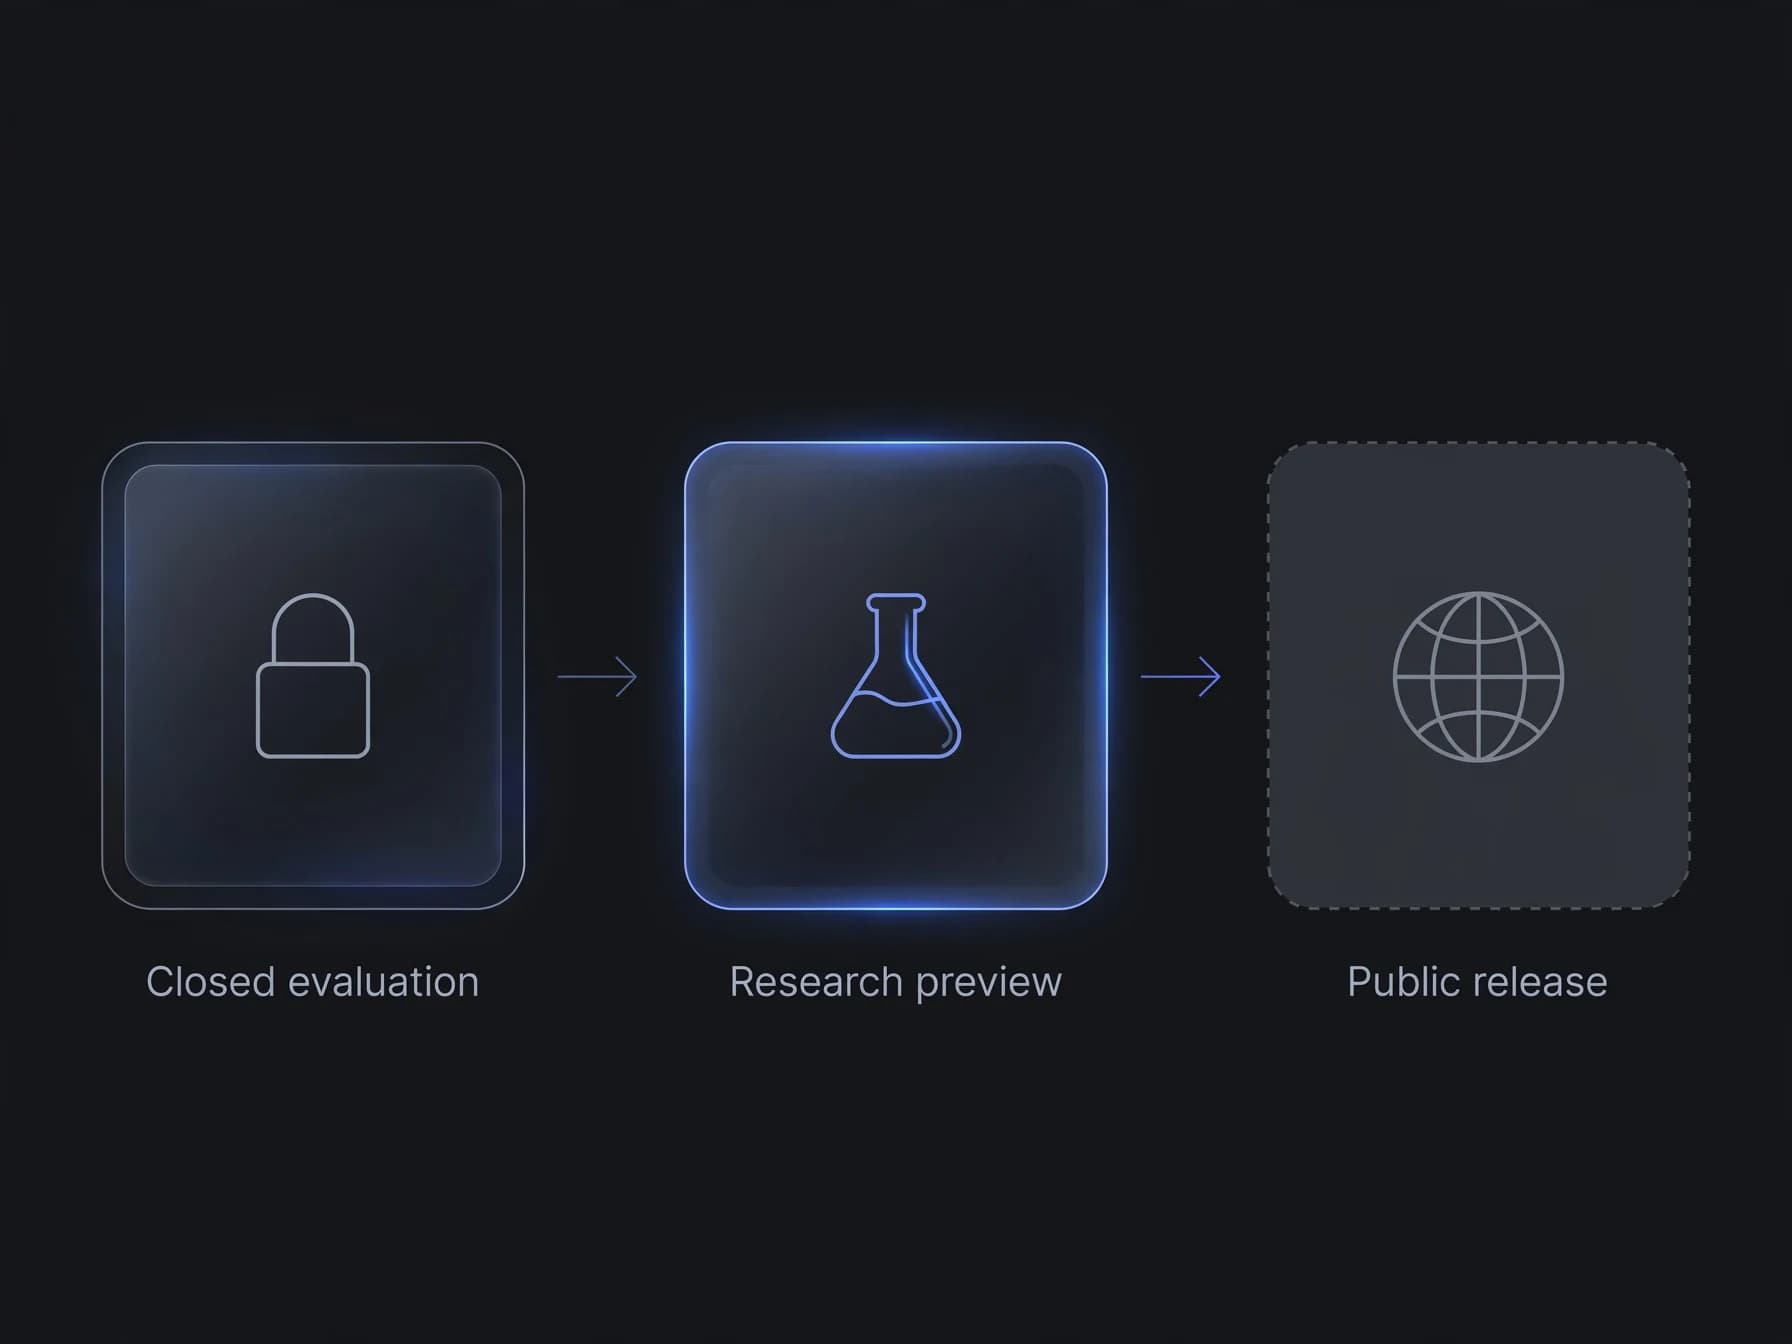
Графік випуску: закрита оцінка, дослідницька версія та майбутній публічний реліз

Інструменти для готових відео з ШІ проти живих діалогових агентів

Щоб зрозуміти переваги діалогових моделей, важливо розрізняти взаємодію в реальному часі та створення готового відео. Живі агенти націлені на миттєві відповіді менш ніж за 200 мілісекунд, дещо поступаючись кінематографічному контролю камери та гнучкості складних текстових промптів.

Натомість генератори готового відео зосереджені на максимальній візуальній деталізації, звукових ефектах і контролі над стилем. Такі платформи, як OnVid, дозволяють генерувати відео тривалістю до 60 секунд на планах Max із текстових описів або звичайних фото, забезпечуючи прямий контроль за темпом і композицією кадрів.

Хоча інтерактивні аватари реального часу з ШІ є в планах розвитку OnVid, створення готових відео залишається найпрактичнішим вибором для маркетингових роликів, контенту для соцмереж та історій. Знайомство з альтернативами Tavus і альтернативами HeyGen допоможе визначитися, чи потрібен вашому проєкту живий діалог із користувачем, чи якісне відео за готовим сценарієм.

Підготовка процесів до роботи з діалоговими відеосистемами на базі Tavus Griffin

Впровадження таких технологій, як відеопайплайн Tavus Griffin, починається з визначення ролі вашого цифрового агента. Інтерактивне відео найкраще підходить для підтримки клієнтів, симуляції навчальних рольових ігор і віртуальних помічників у прямому ефірі, де критично важливий двосторонній зв'язок.

Крок 1 — перевірте вимоги до затримки, щоб зрозуміти, що краще підходить для вашої мети: пряма трансляція чи попередньо згенероване відео. Крок 2 — протестуйте портретні вихідні матеріали з якісним освітленням, щоб моделі генерації аватарів зберігали стабільні риси обличчя під час мовлення.

Крок 3 — встановіть чіткі межі та правила ведення діалогу, щоб цифрові персонажі залишалися переконливими під час спілкування з користувачами. Підготовка цих ресурсів уже зараз допоможе вашій команді швидко почати роботу, коли діалогові відеоплатформи стануть доступними для всіх.
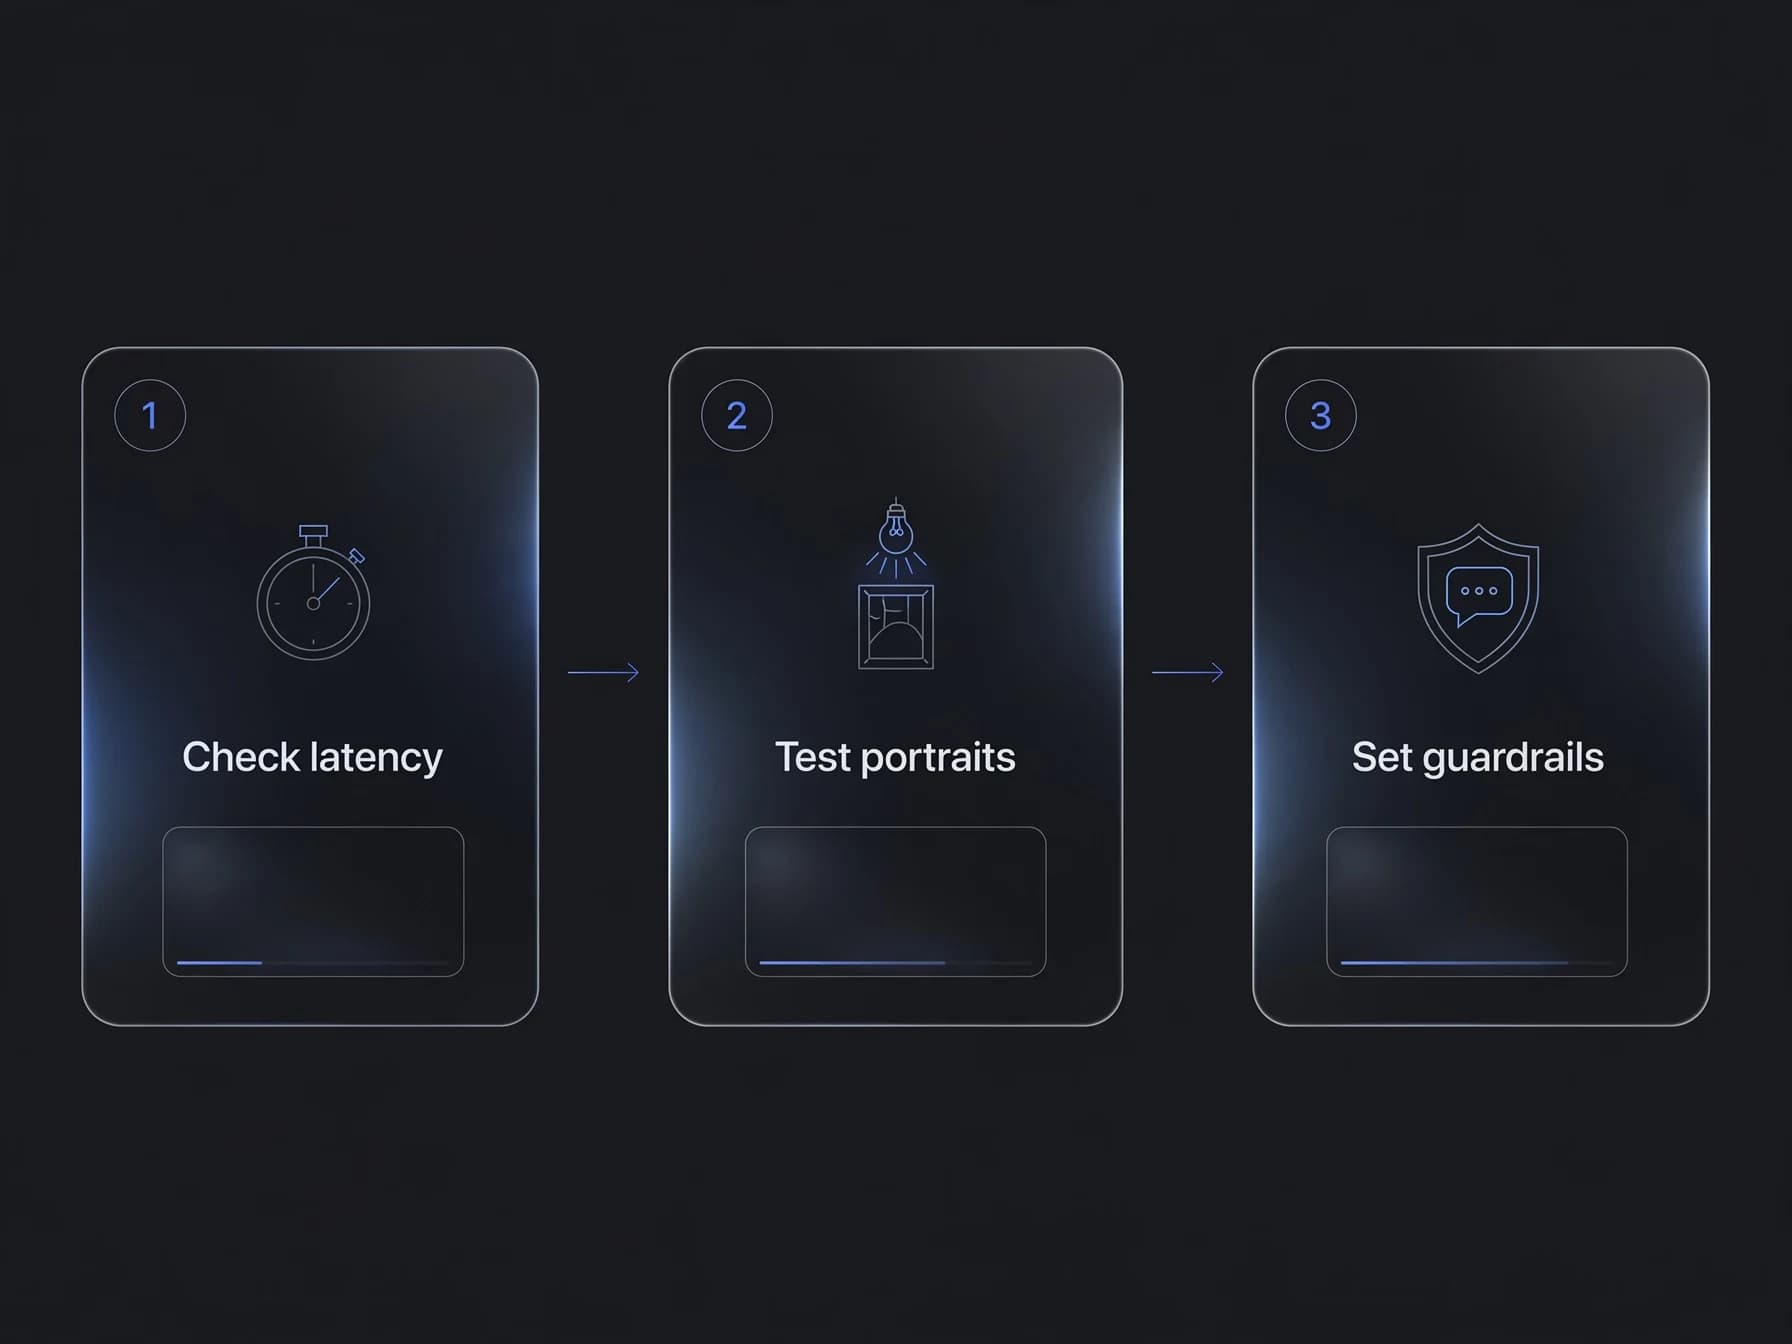
Три кроки підготовки до живого відео з ШІ: перевірка затримки, тестування портретів, налаштування правил

Головне про Tavus Griffin українською

Tavus Griffin демонструє, як швидко діалогові моделі скорочують розрив у візуальному реалізмі, наближаючи інтерактивних ШІ-агентів до природного людського спілкування.

Хоча результати досліджень свідчать про вражаючу швидкість реакції та високі оцінки сприйняття, творцям контенту все одно доводиться обирати між динамічним діалогом і надійним контролем над візуалом. Відстеження цих оновлень допоможе вам обирати правильні інструменти, поки взаємодія в реальному часі та згенеровані відео з ШІ продовжують розвиватися.

Часті запитання про Tavus Griffin

Отримайте чіткі відповіді про технічні тести, особливості архітектури та обмеження пробної версії моделі Tavus Griffin і діалогових агентів реального часу.

Що таке Tavus Griffin?

Tavus Griffin — це архітектура ШІ-моделі, розроблена для діалогових відеоагентів реального часу. Представлена 1 жовтня 2026 року, модель Tavus Griffin створена для двосторонньої візуальної взаємодії з низькою затримкою та природним таймінгом розмови. Вона знаменує перехід від звичайного покрокового рендерингу до безперервного інтерактивного спілкування.

Чи пройшов Tavus Griffin тест Тюрінга у реальному часі?

Під час сліпого тесту з хвилинними відеодзвінками серед 54 учасників 48% визнали Tavus Griffin справжньою людиною. Це суттєвий прогрес порівняно з попереднім стеком Tavus, де результат складав 2,4% (1 оцінювач із 41). Хоча це не стовідсотковий результат, система стала першою задокументованою моделлю, яка досягла майже рівних шансів у візуальному тесті Тюрінга в реальному часі.

Які результати показав Tavus у бенчмарку NVIDIA VideoFDB?

Архітектура посіла перше місце в бенчмарку NVIDIA VideoFDB, який оцінює діалогові відеосистеми. Вона отримала 3,83 бала за візуальну генерацію (проти 3,92 у людини) та 3,73 бала за сприйняття (проти 4,20 у людини). Ці показники оцінюють, наскільки природно система передає міміку, напрямок погляду та реакції слухача під час бесіди.

Що таке дуплексне відео з ШІ в діалогових агентах?

Повнодуплексне відео з ШІ — це безперервний двосторонній потік, де людина та ШІ можуть одночасно говорити, слухати й перебивати одне одного будь-якої миті. Замість того, щоб чекати паузи співрозмовника для обробки відповіді, система аналізує вхідний звук і водночас рендерить кадри відео. Це підтримує природну реакцію на кшталт кивків головою чи коротких словесних підтверджень.

Як побудований стек агентів у Tavus ШІ?

Платформа Tavus ШІ об'єднує спеціалізовані моделі в діалогових агентів під назвою PALs. Стандартний пайплайн використовує Sparrow-2 для ведення діалогу, Phoenix-4.5 для генерації відео із затримкою приблизно 134 мілісекунди та Raven-1 для сенсорного сприйняття. Новіша модель Griffin об'єднує сприйняття та генерацію візуалу в єдину діалогову систему.

Чим такі інструменти, як OnVid, відрізняються від Tavus Griffin?

На відміну від Tavus Griffin, OnVid створює готові відео за текстовими запитами чи фото за допомогою таких моделей, як Seedance 2.5, а не веде живі дзвінки.

Чи можна в OnVid створювати відео з диктором, який говорить?

Так. OnVid створює відео з дикторами та синхронізацією губ з одного фото за допомогою моделей OmniHuman та Kling ШІ Avatar v2 на сторінці створення фото, що говорить.

Які моделі генерації тексту у відео підтримує OnVid?

OnVid пропонує передові моделі: Seedance 2.5, Kling 2.5 Turbo та Veo 3.1. Кредити списуються посекундно, а в разі помилки автоматично повертаються.

Чи доступний Tavus Griffin для всіх просто зараз?

Tavus надав доступ до Griffin-Lite виключно в межах закритого дослідницького прев'ю для обраних тестувальників і партнерів. Повна архітектура наразі недоступна у стандартному інтерфейсі PAL Maker або публічному API. Офіційні ціни та дати відкритого релізу поки не оголошені.

Скільки коштує Tavus для звичайних розмовних відеоагентів?

Tavus пропонує кілька тарифів: від базового до індивідуального для бізнесу. Перегляньте наш докладний посібник, щоб дізнатися все про плани та ліміти використання.

Скільки коштує генерація відео з ШІ на OnVid?

Після реєстрації ви отримаєте доступ для знайомства з платформою, перш ніж обирати платну підписку. План Pro коштує 7,99 $ на тиждень або 14,99 $ на місяць, а Max — 14,99 $ на тиждень або 28,99 $ на місяць. Обидві підписки дають змогу завантажувати HD-відео без водяних знаків, а витрата кредитів залежить від обраної моделі та тривалості відео.

Чи можна використовувати відео з ШІ для комерційних проєктів?

Комерційне використання залежить від обраної моделі. Перед використанням ознайомтеся з Умовами надання послуг OnVid та правилами конкретної моделі.

Чи вміє Tavus створювати аватари за одним фото?

Tavus підтримує створення цифрових копій як з однієї фотографії, так і з короткого відео. Після обробки створене обличчя можна використовувати в розмовних агентах PAL для автоматизованого спілкування. Для звичайних роликів такі інструменти, як OnVid, анімують портретні фото та створюють розмовні відео за допомогою синхронізації губ.

Де знайти альтернативи Tavus для створення відео?

Ви можете прочитати наш докладний огляд альтернатив Tavus і порівняти розмовних агентів реального часу зі звичайними інструментами генерації. Для маркетингових роликів, сюжетних відео чи публікацій у соцмережах зазвичай найкраще підходять генератори тексту у відео та зображення у відео. Вибір залежить від того, що саме вам потрібно: відеодзвінки наживо чи готові файли для завантаження.

Що вимірює відео тест Тьюрінга для штучного інтелекту?

Відео тест Тьюрінга перевіряє, чи можуть учасники відрізнити ШІ-аватара у відеодзвінку від справжньої людини. Зазвичай люди ведуть коротку бесіду, оцінюючи якість картинки, мікровирази обличчя та затримку у відповідях. Щоб успішно пройти тест, аватар має говорити без неприродних пауз, асинхрону губ і затримок зв'язку.

Як розмовні відеомоделі реагують, коли їх перебивають?

Сучасні розмовні системи використовують аудіомоделі, які розпізнають людську мову, навіть коли аватар говорить сам. Щойно користувач починає говорити, система миттєво припиняє генерацію поточної відповіді та переводить аватара в режим уважного слухача. Завдяки цій швидкій реакції аватар не перебиває співрозмовника, і діалог звучить природно.

Схожі блоги

More from the blog

Переглянути більше