Tavus Griffin nedir ve nasıl çalışır?
Tavus Griffin, diyalog gerçekçiliğini ölçmek için tasarlanan canlı bir video Turing testine katılarak sentetik medya dünyasında önemli bir dönüm noktası oluşturdu. Tavus tarafından geliştirilen Griffin, karşılıklı video görüşmelerinde konuşan, dinleyen ve tepki veren dijital karakterlere güç sağlamak amacıyla üretilmiş gelişmiş bir model mimarisidir.
Geleneksel video modelleri metin istemlerinden veya fotoğraflardan sırayla videolar oluşturur. Griffin ise canlı konuşmacıdan gelen ses verisini işlerken aynı anda akıcı yüz hareketlerini, konuşmaları ve mikro mimikleri eş zamanlı olarak sunar.
1 Ekim 2026'da duyurulan bu teknoloji, önceden kaydedilmiş yapay zeka videoları ile anlık etkileşimli görüşmeler arasındaki farkı kapatmayı hedefler. Dijital sunucuların uzun süreli görüşmeleri doğal bir akışla sürdürebilmesi için mimikleri ve vokal duraklamaları hassasiyetle modeller.
Tavus Griffin testlerde insan performansına karşı nasıl ölçüldü?
Kapsamlı bir yapay zeka Turing testi değerlendirmesinde araştırmacılar, katılımcıların otomatik bir sistemi gerçek bir insandan anlık olarak ayırt edip edemeyeceğini inceledi. 54 katılımcıyla gerçekleştirilen bir dakikalık canlı video görüşmesi testinde, katılımcıların yüzde 48'i gerçek bir insanla konuştuğunu düşündü. Buna karşılık, önceki Tavus altyapısı 41 değerlendiriciden yalnızca birini (yüzde 2,4) ikna edebilmişti.
Sistem ayrıca NVIDIA VideoFDB etkileşim testinde birinci sıraya yerleşti. İnsan videosundaki 3,92 puanlık gerçekçilik seviyesine karşı 3,83 puan aldı; 4,20 puanlık insan algı derecesine karşı ise 3,73 puana ulaştı.
Bu veriler, gerçek zamanlı video üretiminin kısa süreli etkileşimlerde insansı algı düzeyine oldukça yaklaştığını gösteriyor. Uzun konuşmalarda sentetik izler hâlâ fark edilse de kısa görüşmeler artık tutarlı bir doğallık sunuyor.
Etkileşimli yapay zeka video asistanlarının arkasındaki akış mimarisi
Hızlı tepki veren gerçek zamanlı bir yapay zeka avatarı kullanmak, görsel kare üretimini anlık diyalog ipuçlarıyla senkronize etmeyi gerektirir. Tavus, bu deneyimi anlama, konuşma zamanlaması ve görsel çıktıyı yöneten özelleşmiş sistemlerle koordine eder.
Süreç, algılama için Raven-1'i; konuşma sırasını yönetmek ve söz kesilmelerine yanıt vermek için Sparrow-2'yi kullanır. Görüntüleme, yaklaşık 134 milisaniyelik düşük gecikmeyle Phoenix-4.5 tarafından yürütülürken Griffin yüksek kaliteli yüz modellemesi ve sürekli çevresel uyum sağlar.
Bu mimari, geliştiricilerin sözü kesildiğinde duraklayan ve konuşmaya doğal bir şekilde devam eden etkileşimli asistanlar oluşturmasına olanak tanır. Yapay zeka avatar oluşturucu gibi üretici araçları fotoğraflardan önceden kaydedilmiş konuşma videoları üretirken, etkileşimli mimariler doğrudan düşük gecikmeli canlı akışa odaklanır.
Tavus Griffin erişimi ve güncel platform durumu
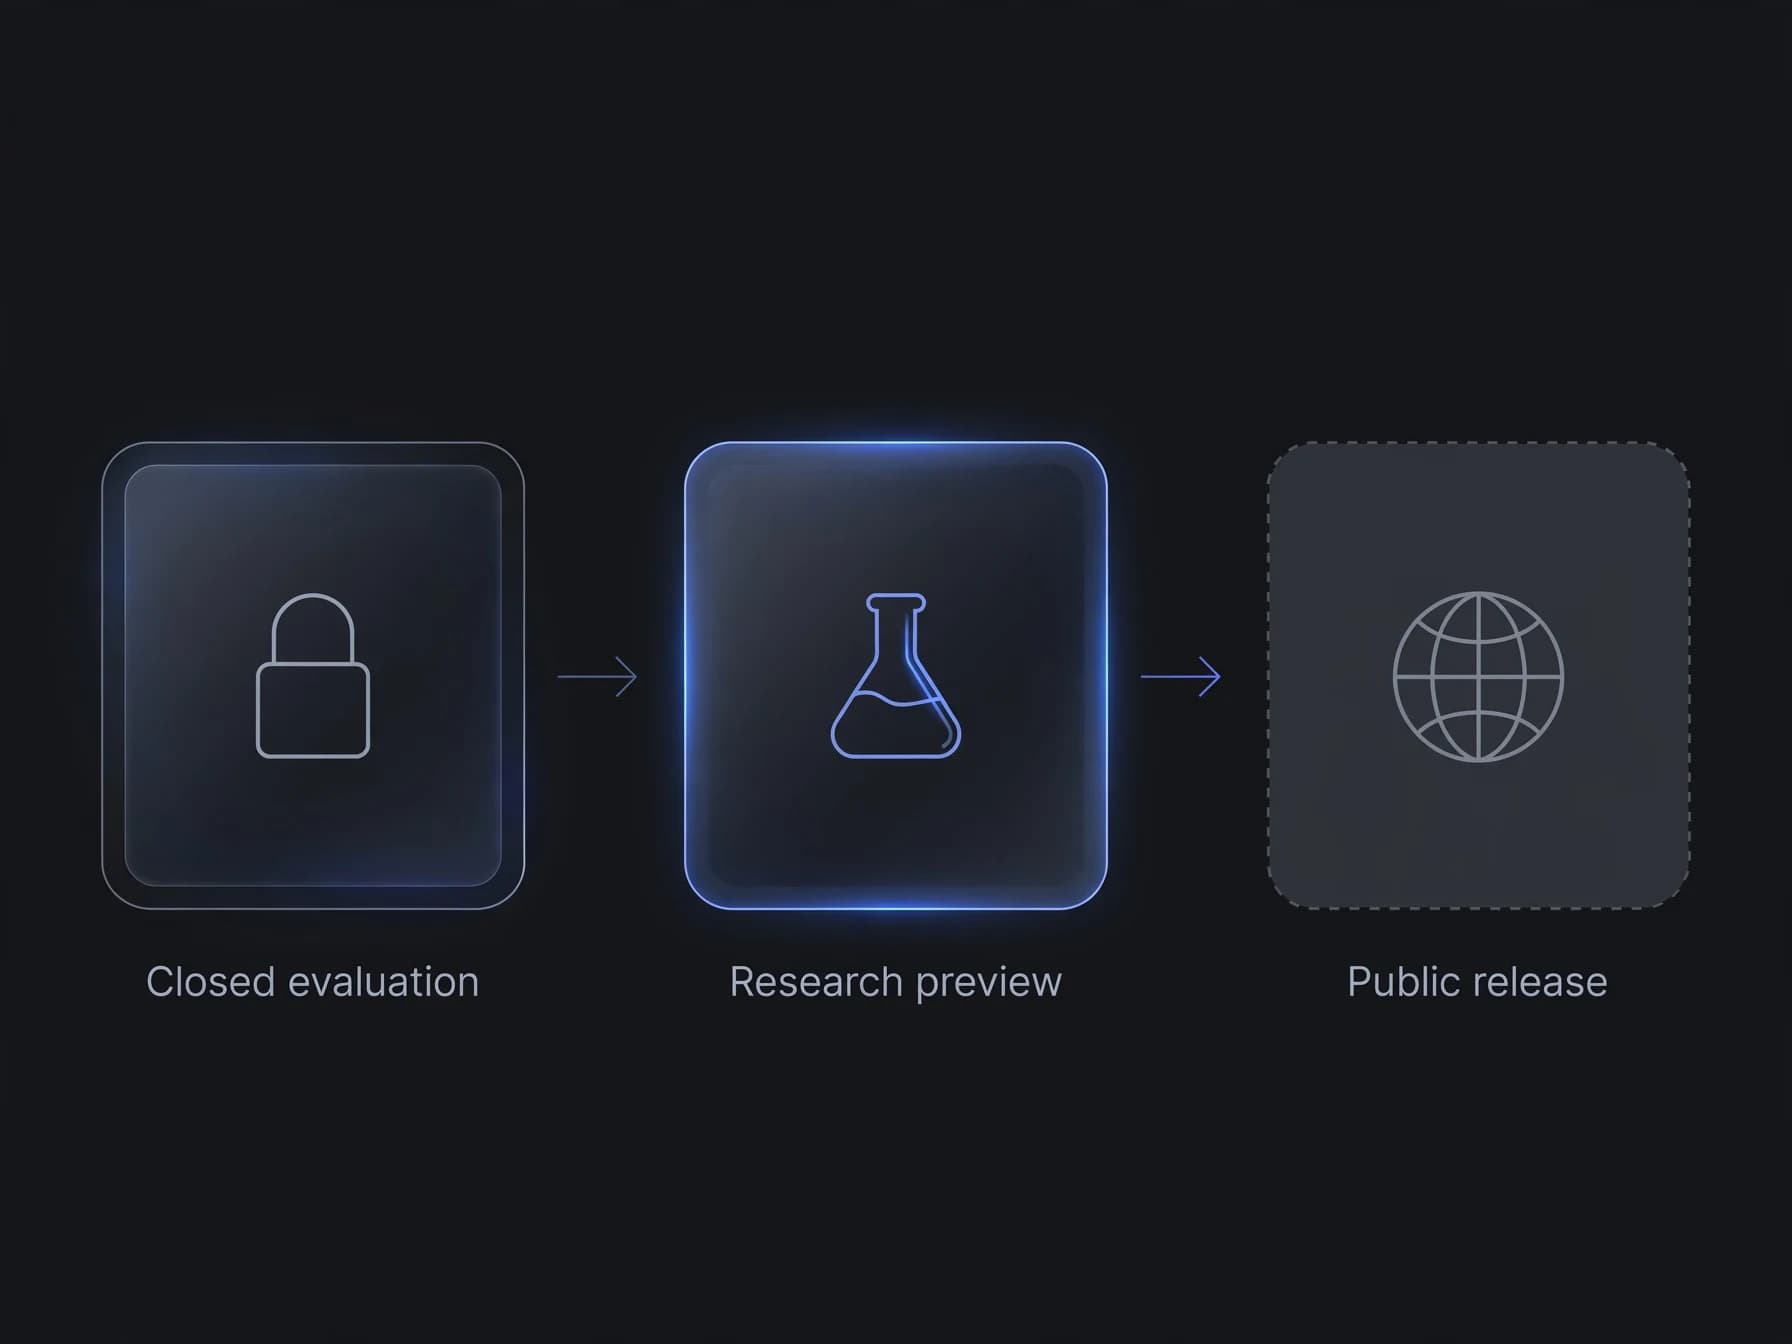
Şirket kapalı değerlendirmeler yürüttüğü için eksiksiz Tavus Griffin yapay zeka sistemine erişim şimdilik sınırlı kalıyor. Yalnızca Griffin-Lite, seçkin geliştirici test kullanıcılarına bir araştırma önizlemesi olarak sunuluyor ve mimarinin genel fiyatlandırması henüz duyurulmadı.
Genel Tavus platformu planları aylık kullanım katmanlarına göre yapılandırılmaya devam ediyor. Bu paketler arasında aylık 20 dakikalık etkileşimli video sunan Ücretsiz plan, ayda 22 $'a Starter planı, ayda 59 $'a Builder katmanı, ayda 397 $'a Growth katmanı ve ayda 975 $'a Business planı yer alıyor.
Mevcut platform özelliklerini kullanan geliştiriciler, kısa bir eğitim videosu veya tek bir referans portre kullanarak özel görsel personalar eğitebilir. Platform, yetkisiz benzerlik kopyalamayı ve canlı oturumlarda kötüye kullanımı engellemek için sıkı güvenlik denetimleri içerir.
Önceden kaydedilmiş yapay zeka video araçları ve canlı etkileşimli ajanlar
Sohbet odaklı modellerin konumunu anlamak, gerçek zamanlı etkileşimi geleneksel video üretiminden ayırmayı gerektirir. Canlı ajanlar, sinematik kamera kontrolünden ve karmaşık komut yönlendirmesinden ödün vererek 200 milisaniyenin altındaki hızlı yanıtlara öncelik verir.
Buna karşılık, önceden kaydedilmiş video oluşturucular maksimum görsel ayrıntıya, ses efektlerine ve stil denetimine odaklanır. OnVid gibi platformlar, metin komutlarından veya fotoğraflardan Max planlarda 60 saniyeye kadar videolar üretmenizi sağlayarak tempo ve sahne kompozisyonu üzerinde doğrudan kontrol sunar.
Gerçek zamanlı interaktif yapay zeka avatarları OnVid yol haritasında yer alsa da, pazarlama videoları, sosyal medya içerikleri ve hikaye anlatımı için önceden kaydedilmiş video üretimi pratik bir seçenek olmaya devam ediyor. Tavus alternatifleri ve popüler HeyGen alternatifleri seçeneklerini incelemek, projenizin canlı kullanıcı diyaloğuna mı yoksa senaryolu video üretimine mi ihtiyaç duyduğunu netleştirmenize yardımcı olur.
İş akışınızı sohbet odaklı Tavus Griffin sistemlerine hazırlama
Tavus Griffin video altyapısı gibi teknolojileri benimsemek, otomatik ajanınızın üstleneceği rolü tanımlamakla başlar. İnteraktif video; müşteri desteği, simüle edilmiş rol yapma eğitimleri ve iki yönlü geri bildirimin vazgeçilmez olduğu canlı sanal asistanlık için idealdir.
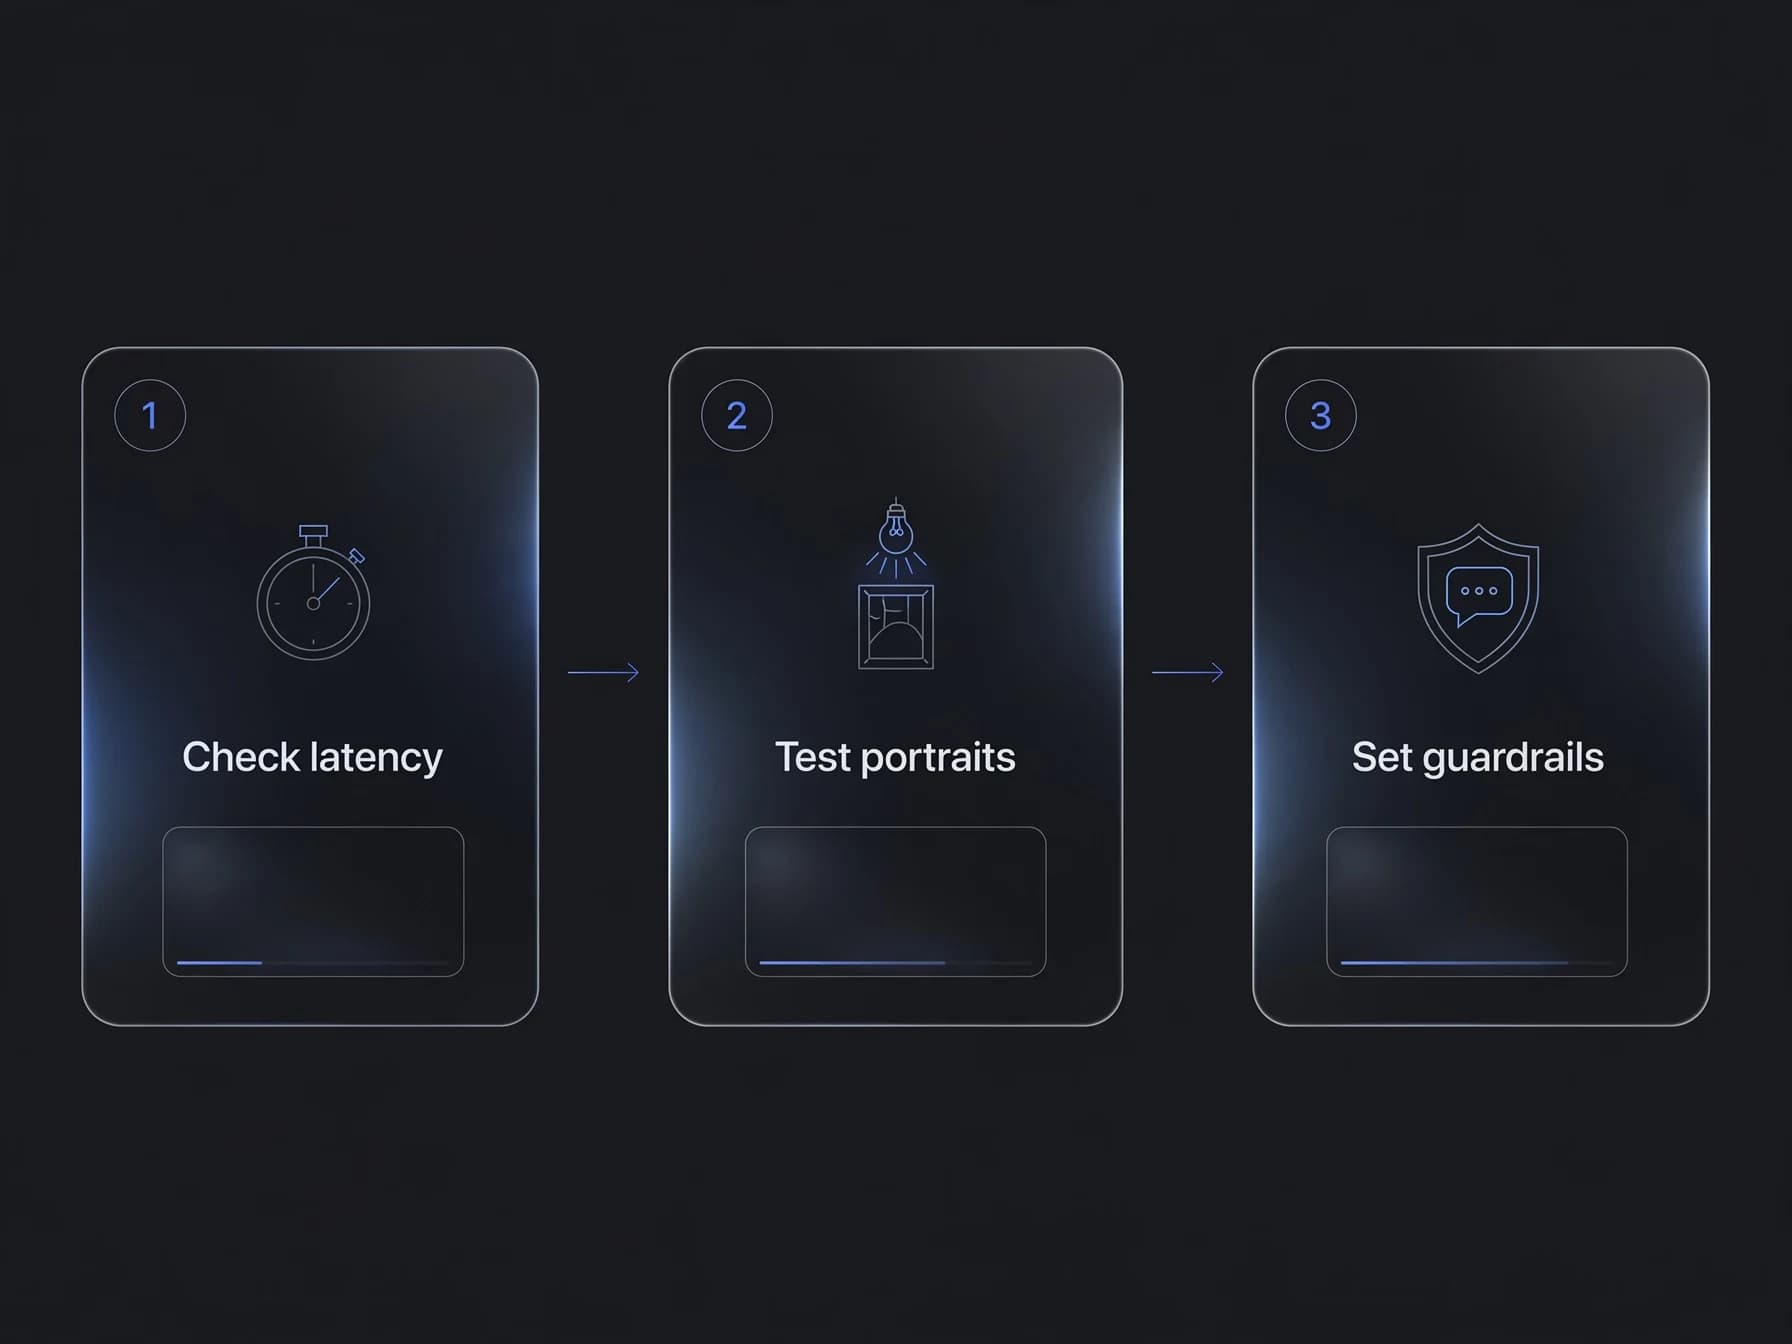
- Adım, canlı yayının mı yoksa önceden işlenmiş videonun mu proje hedeflerinize uyduğunu belirlemek için gecikme gereksinimlerinizi denetlemektir. 2. Adım, avatar işleme modellerinin konuşma sırasında yüz hatlarını sabit tutabilmesi adına portre materyallerini temiz ışıklandırmayla test etmeyi içerir.
- Adım ise sentetik personaların canlı kullanıcı etkileşimlerinde bağlamdan kopmaması için net konuşma sınırları belirlemeyi gerektirir. Bu varlıkları şimdiden hazırlamak, sohbet odaklı video platformları daha geniş kitlelere açıldığında ekibinizin hazır olmasını sağlar.