Was ist Tavus Griffin und wie funktioniert das Modell?
Tavus Griffin setzt neue Maßstäbe für synthetische Medien und trat in einem Live-Video-Turing-Test an, um dialogischen Realismus zu messen. Griffin wurde von Tavus entwickelt und ist eine fortschrittliche Architektur für digitale Avatare, die in echten Videoanrufen sprechen, zuhören und reagieren.
Klassische Videomodelle erstellen Videos nacheinander aus Prompts oder Fotos. Griffin streamt stattdessen flüssige Gesichtsbewegungen, gesprochenen Dialog und feine Reaktionen synchron, während es die Audiosignale des Gesprächspartners in Echtzeit verarbeitet.
Die am 1. Oktober 2026 vorgestellte Technologie schließt die Lücke zwischen vorgerenderten Clips und dynamischer Interaktion. Sie modelliert Mikromimik und Sprachtiming so präzise, dass digitale Sprecher flüssige Gespräche führen können.
So schnitt Tavus Griffin im Benchmark-Test gegen Menschen ab
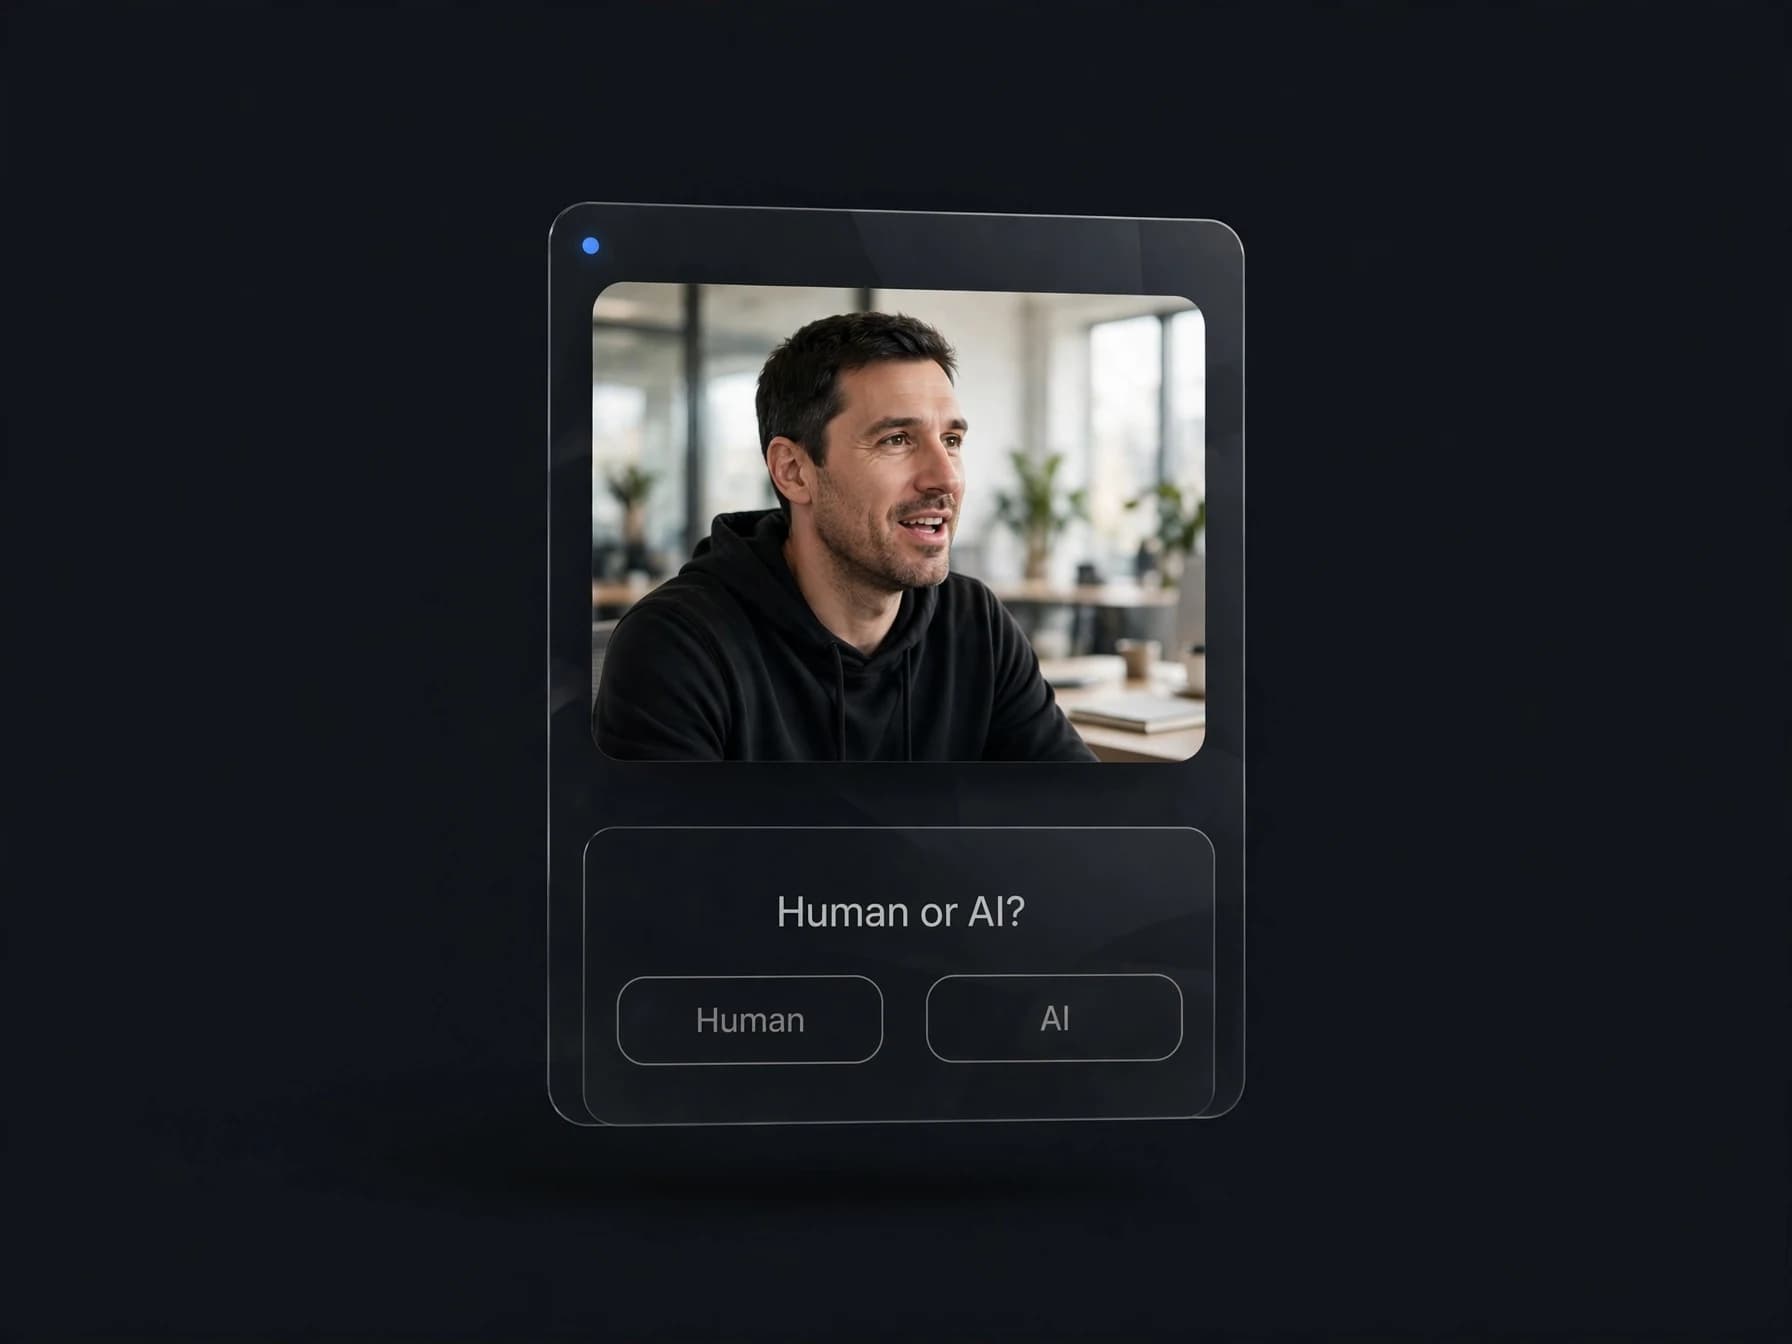
In einem anspruchsvollen KI-Turing-Test untersuchten Forschende, ob Testpersonen ein automatisiertes System in Echtzeit von einem echten Menschen unterscheiden können. In einminütigen Videoanrufen mit 54 Teilnehmenden glaubten 48 Prozent, mit einem echten Menschen zu sprechen. Zum Vergleich: Das Vorgängersystem überzeugte lediglich 2,4 Prozent (einen von 41 Testern).
Zudem belegte das System den Spitzenplatz im NVIDIA-VideoFDB-Benchmark mit einem Realismuswert von 3,83 gegenüber 3,92 bei echten Videos sowie einer Wahrnehmungsbewertung von 3,73 gegenüber 4,20 beim Menschen.
Diese Werte zeigen, dass Echtzeit-Videogenerierung bei kurzen Interaktionen fast menschliches Niveau erreicht. Zwar treten bei längeren Gesprächen noch Artefakte auf, doch kurze Dialoge wirken bereits verblüffend lebensecht.
Die Streaming-Architektur hinter Tavus Griffin und KI-Agenten
Ein interaktiver Echtzeit-KI-Avatar erfordert die exakte Synchronisation von Bildgenerierung und Gesprächsdynamik. Tavus steuert diesen Ablauf über spezialisierte Einzelsysteme für Sprachverständnis, Timing und Bildausgabe.
Die Pipeline nutzt Raven-1 für die Wahrnehmung und Sparrow-2 für Sprecherwechsel und Unterbrechungen. Das Rendering übernimmt Phoenix-4.5 mit einer niedrigen Latenz von rund 134 Millisekunden, während Griffin für die detaillierte Mimik und Anpassung an die Umgebung sorgt.
Mit diesem Aufbau können Entwickler Agenten bauen, die bei Unterbrechungen pausieren und danach flüssig fortfahren. Während Tools wie ein KI-Avatar-Generator vorgerenderte Clips aus Fotos erstellen, konzentriert sich Tavus Griffin voll auf das Streaming in Echtzeit.
Tavus Griffin: Zugang und aktuelle Verfügbarkeit
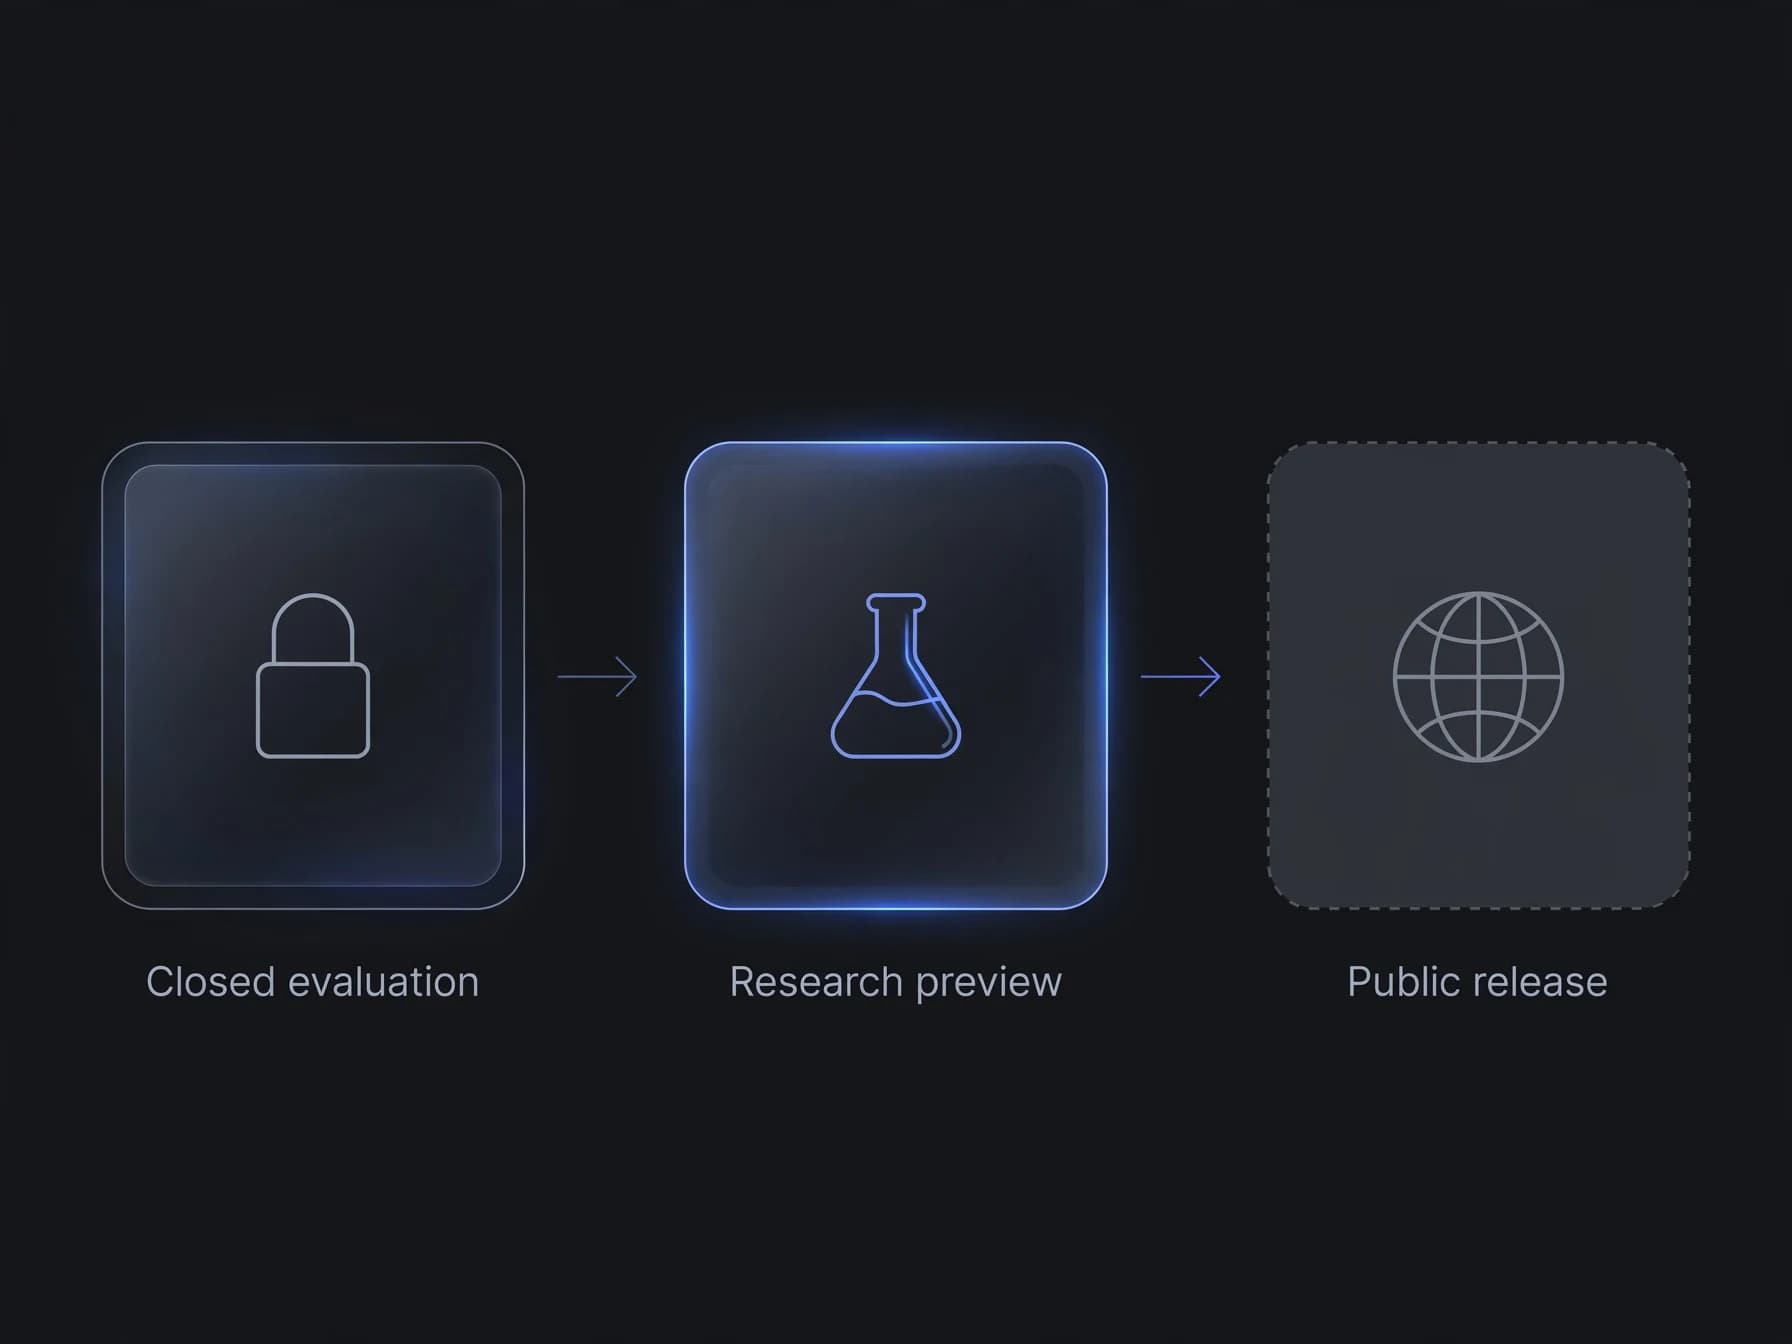
Der Zugriff auf das vollständige KI-System Tavus Griffin bleibt begrenzt, da das Unternehmen noch geschlossene Tests durchführt. Nur Griffin-Lite ist derzeit als Research-Preview für ausgewählte Entwickler verfügbar, und offizielle Preise für diese Architektur wurden noch nicht bekannt gegeben.
Die regulären Tarife der Tavus-Plattform basieren weiterhin auf monatlichen Nutzungskontingenten. Dazu gehören ein kostenloser Tarif mit 20 Minuten dialogbasiertem Video pro Monat, ein Starter-Plan für 22 $ pro Monat, ein Builder-Tarif für 59 $ pro Monat, ein Growth-Tarif für 397 $ pro Monat sowie ein Business-Plan für 975 $ pro Monat.
Entwickler, die aktuelle Plattformfunktionen nutzen, können eigene visuelle Personas mit einem kurzen Trainingsvideo oder einem einzelnen Referenzporträt trainieren. Die Plattform enthält strenge Sicherheitsprüfungen, um die unbefugte Nachbildung von Personen und Missbrauch bei Live-Sitzungen zu verhindern.
Vorab gerenderte KI-Videotools im Vergleich zu interaktiven Live-Agenten
Um zu verstehen, wo dialogorientierte Modelle am besten passen, muss man Echtzeit-Interaktion von klassischer Videoerstellung trennen. Live-Agenten setzen auf extrem schnelle Reaktionszeiten unter 200 Millisekunden, verzichten dafür aber auf filmreife Kamerasteuerung und detailreiches Prompting.
Im Gegensatz dazu konzentrieren sich Generatoren für vorab gerenderte Videos auf maximale visuelle Details, Soundeffekte und volle Stilkontrolle. Auf Plattformen wie OnVid kannst du Videos von bis zu 60 Sekunden in den Max-Plänen aus Text-Prompts oder Fotos erstellen – mit voller Kontrolle über Timing und Bildaufbau.
Interaktive KI-Avatare in Echtzeit stehen zwar auch bei OnVid auf der Roadmap, doch vorab gerenderte Videos bleiben die praktischere Wahl für Marketing-Videos, Social-Media-Content und Storytelling. Ein Blick auf Tavus Alternativen und beliebte HeyGen Alternativen zeigt dir schnell, ob dein Projekt einen echten Live-Dialog oder eine gezielte Videoproduktion nach Skript erfordert.
So bereitest du deinen Workflow auf Tavus Griffin und dialogbasierte KI vor
Wenn du Technologien wie eine Video-Pipeline mit Tavus Griffin nutzen willst, solltest du zuerst die Rolle deines automatisierten Agenten genau definieren. Interaktive Videos eignen sich am besten für den Kundensupport, simulierte Rollenspiele im Training und virtuelle Live-Assistenz, bei der beidseitiges Feedback unverzichtbar ist.
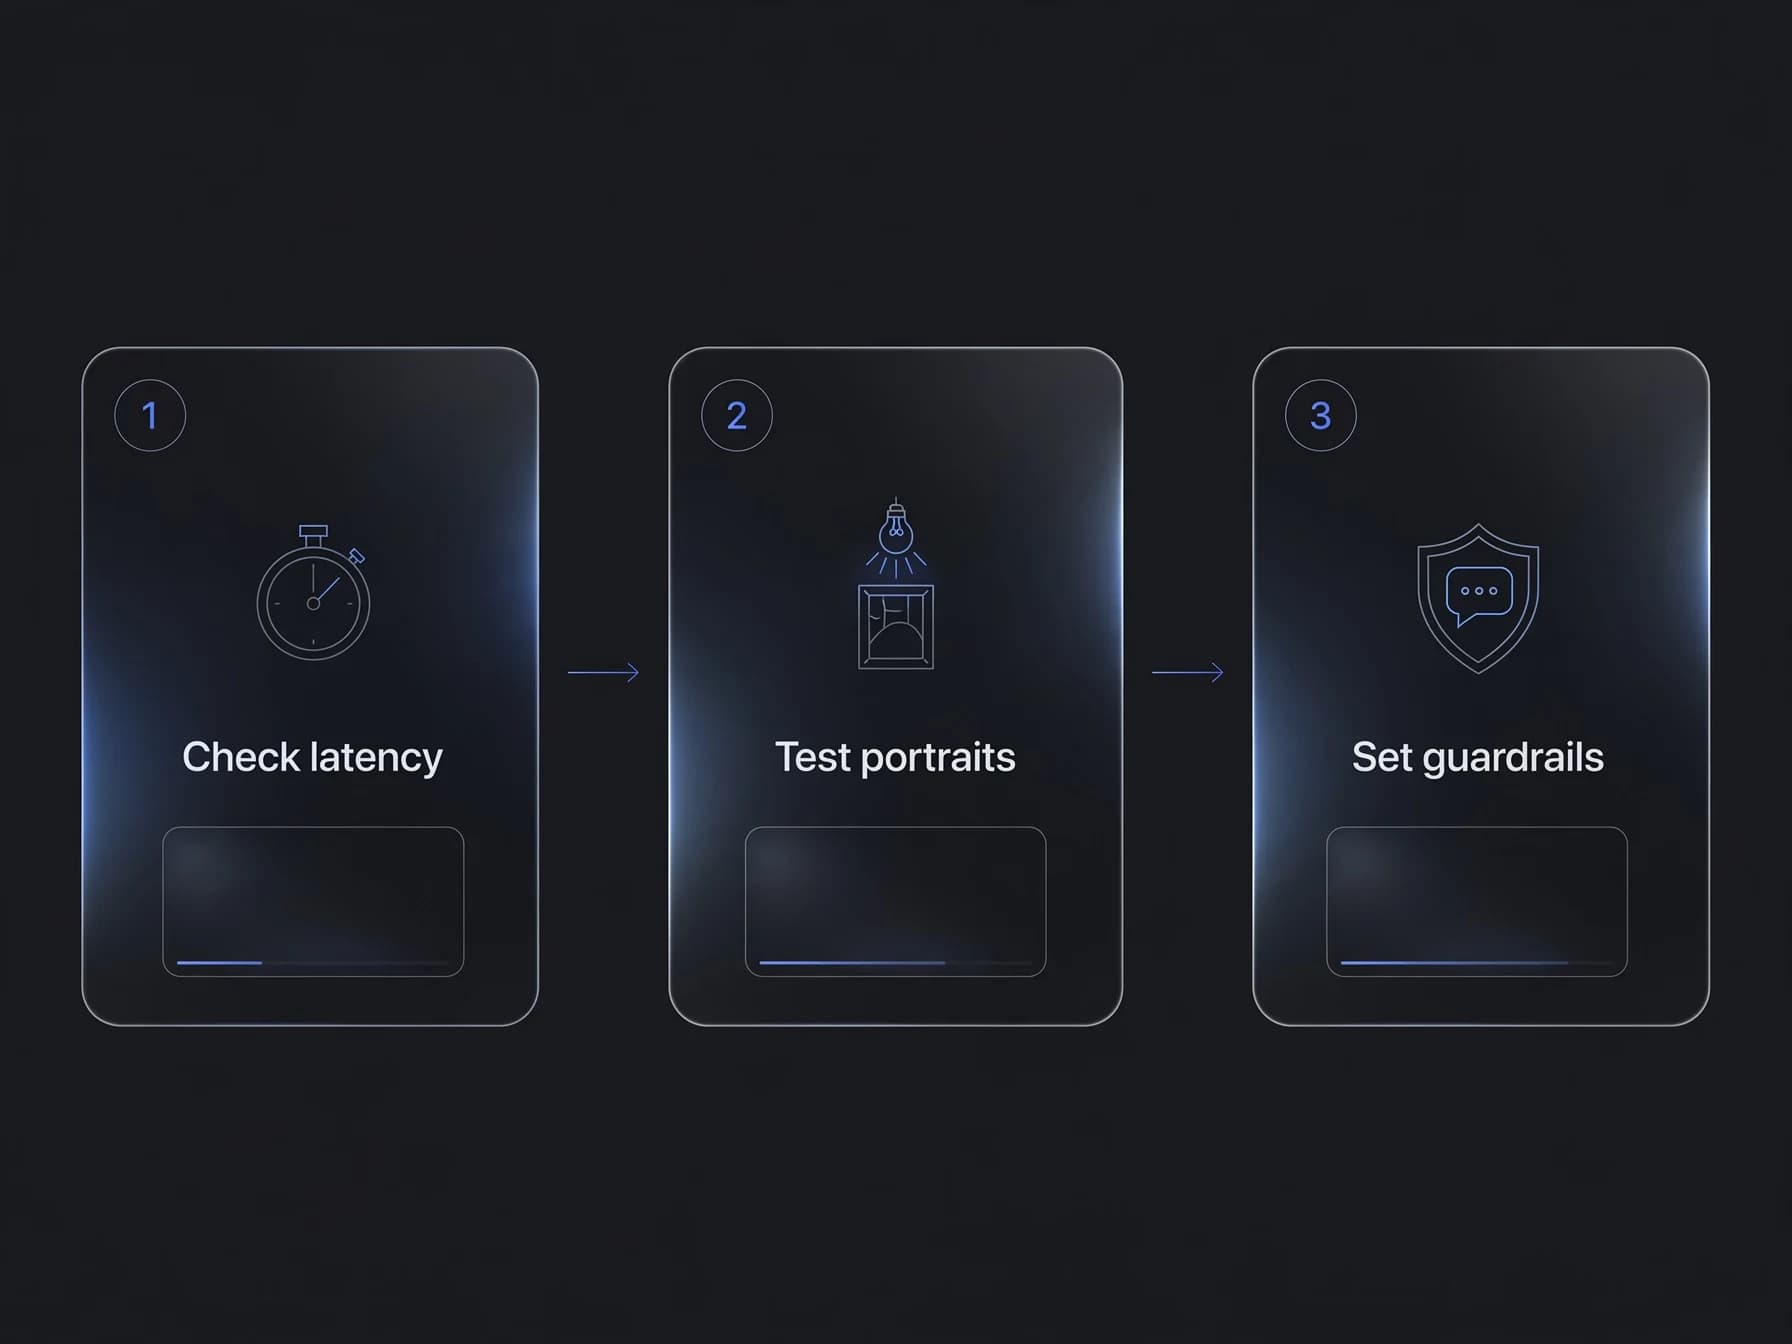
Schritt 1: Prüfe deine Latenzanforderungen, um festzustellen, ob ein Live-Stream oder ein v
Schritt 3: Richte klare Leitplanken für Dialoge ein, damit synthetische Personas in Live-Ge