12 novembre 2026
9 min de lecture
Industry Insights

Tavus Griffin : la première IA à réussir le test de Turing vidéo

Tavus Griffin est un modèle vidéo d'IA conversationnelle interactive conçu pour mener des appels vidéo en temps réel. Il offre une alternance de parole naturelle, des mouvements de visage fluides et un temps de réponse vocal inférieur à la seconde. Lors de récents tests à l'aveugle, 48 % des participants ont pensé échanger avec un véritable humain après une minute d'interaction.

Par Vérifié par Jonah WellerComment nous vérifions

Tavus Griffin : présentation et fonctionnement du modèle

Tavus Griffin marque un tournant majeur dans les médias synthétiques en réussissant un test de Turing vidéo en direct destiné à évaluer le réalisme conversationnel. Développé par Tavus, Griffin repose sur une architecture de modèle conversationnel avancée conçue pour animer des personas numériques capables de parler, d'écouter et de réagir lors d'appels vidéo bidirectionnels.

Les modèles vidéo traditionnels génèrent des vidéos séquentiellement à partir d'invites textuelles ou de photos fixes. Griffin fonctionne différemment : il diffuse en continu des expressions faciales fluides, des dialogues parlés et des réactions subtiles tout en analysant la voix de son interlocuteur en direct.

Dévoilée le 1er octobre 2026, cette technologie vise à combler l'écart entre les vidéos synthétiques préenregistrées et les interactions vidéo en direct. Elle reproduit les micro-expressions du visage et le rythme naturel de la parole pour permettre aux présentateurs numériques de tenir de véritables conversations vidéo.

Tavus Griffin face aux performances humaines : les résultats des tests

Lors d'une évaluation rigoureuse basée sur le test de Turing pour l'IA, les chercheurs ont cherché à savoir si des observateurs pouvaient faire la différence entre un système automatisé et une personne réelle en temps réel. Lors d'un test d'appel vidéo en direct d'une minute auprès de 54 participants humains, 48 % ont cru s'adresser à un véritable humain. En comparaison, la version précédente de Tavus n'avait convaincu que 2,4 % des participants, soit un seul évaluateur sur 41.

Le système s'est également hissé à la première place du benchmark conversationnel NVIDIA VideoFDB. Il a obtenu un score de réalisme de génération de 3,83 contre 3,92 pour une vidéo humaine, ainsi qu'une note de perception de 3,73 contre 4,20 pour les performances humaines.

Ces résultats démontrent que la génération de vidéo en temps réel approche d'une équivalence visuelle sur des interactions courtes. Même si des échanges prolongés laissent encore apparaître des défauts visuels synthétiques, les conversations rapides imitent désormais la présence humaine avec une justesse remarquable.
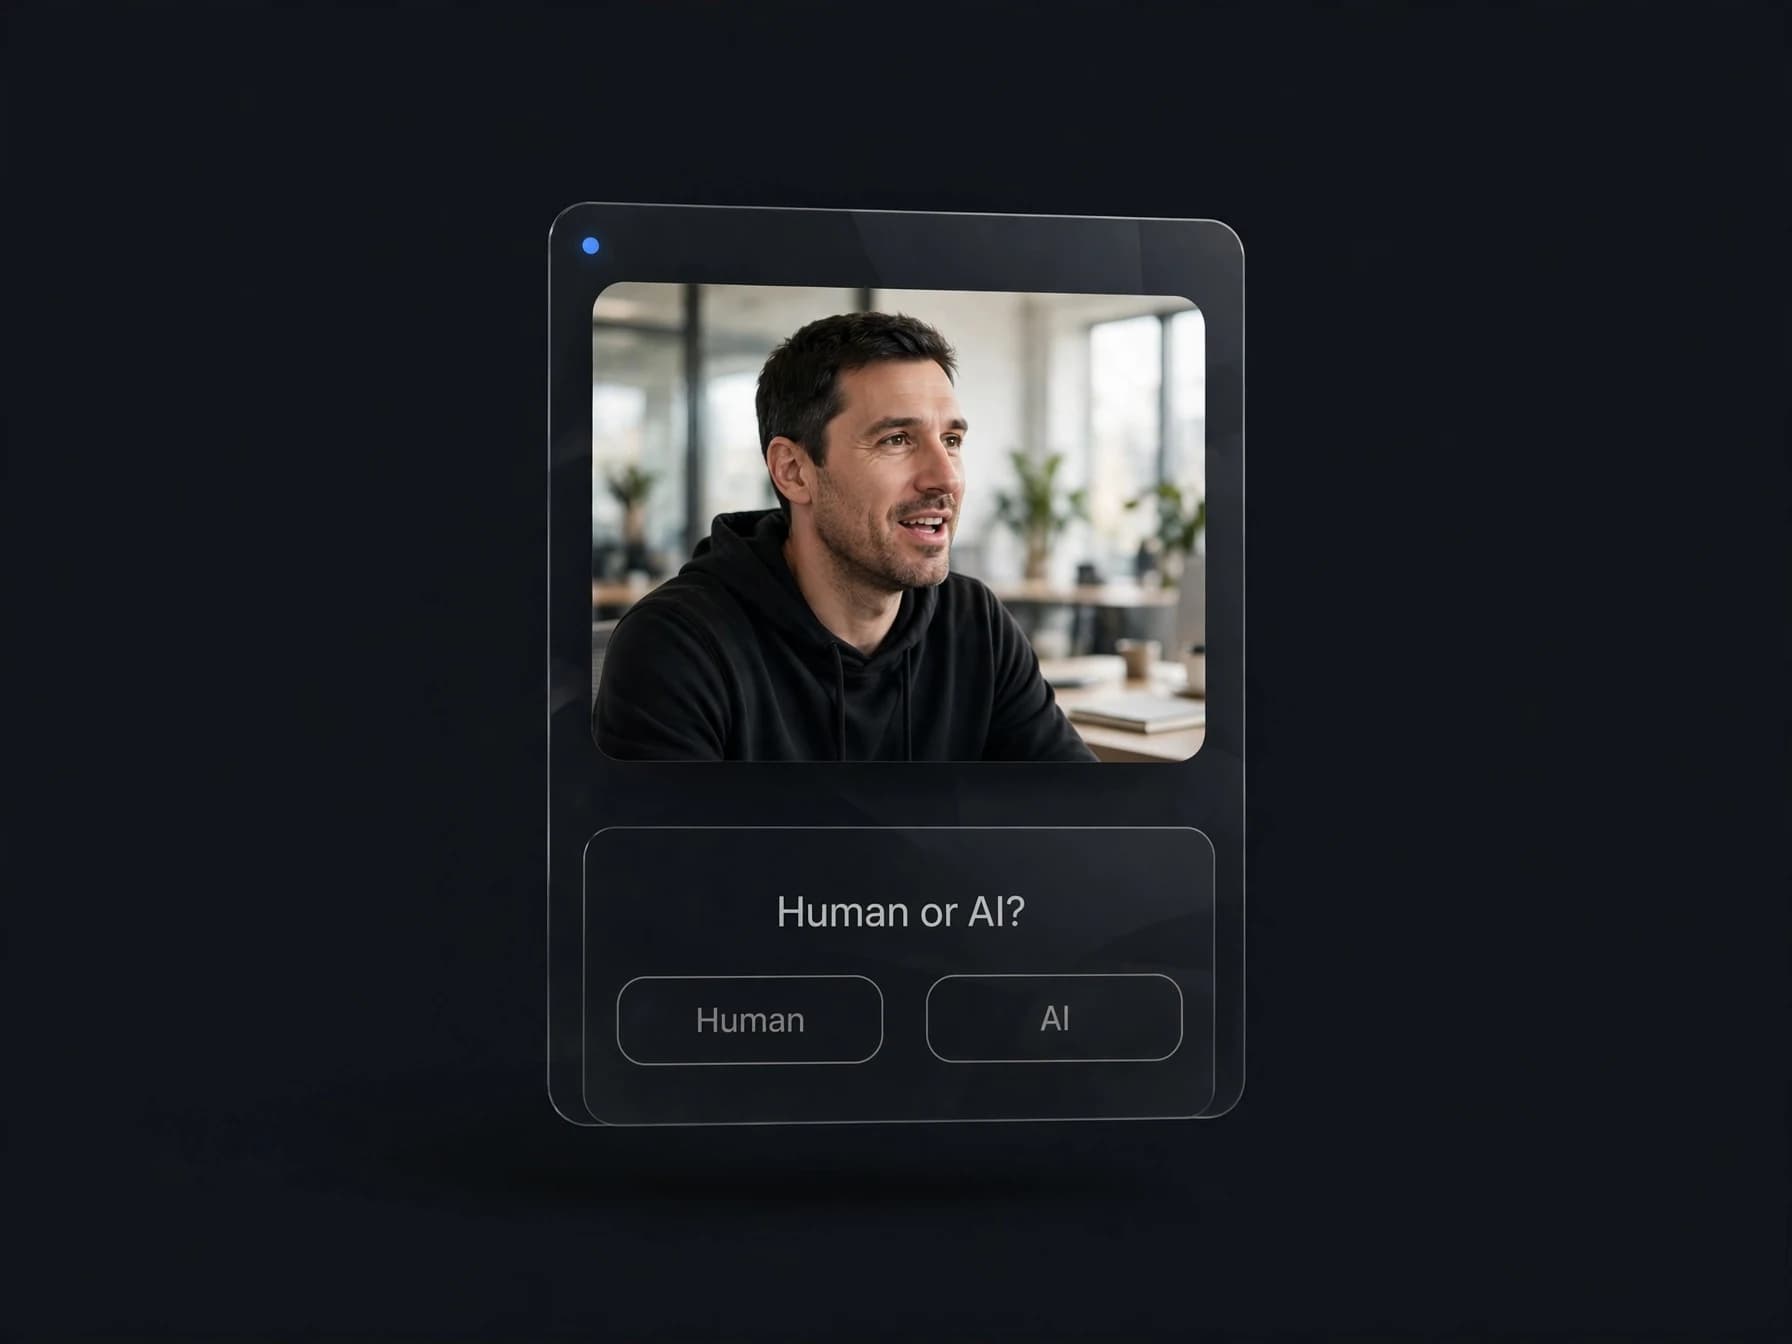
Appel vidéo en direct avec un sondage demandant si la personne à l'écran est un humain ou une IA

L'architecture de streaming derrière les agents vidéo conversationnels par IA

Déployer un avatar IA réactif en temps réel exige de synchroniser parfaitement le rendu des images avec le rythme naturel de la conversation. Tavus orchestre cette expérience à l'aide de plusieurs systèmes spécialisés qui gèrent la compréhension, le timing vocal et le rendu visuel.

Le pipeline s'appuie sur Raven-1 pour la perception sensorielle et sur Sparrow-2 pour l'alternance de parole et la gestion des interruptions. Le rendu graphique est confié à Phoenix-4.5 avec une latence réduite à environ 134 millisecondes, tandis que Griffin assure la modélisation faciale haute fidélité et l'adaptation continue à l'environnement.

Cette architecture permet aux développeurs de créer des agents conversationnels capables de s'interrompre dès que vous prenez la parole et de reprendre naturellement leur discours. Alors que les outils de création comme un générateur d'avatar IA produisent des vidéos parlantes préenregistrées et soignées à partir de photos, les architectures conversationnelles se concentrent exclusivement sur le streaming à ultra-faible latence.

Accéder à Tavus Griffin et disponibilité actuelle de l'outil

L'accès au système IA complet Tavus Griffin reste restreint pendant les phases de tests fermés. Seule la version Griffin-Lite est proposée en aperçu de recherche pour quelques développeurs sélectionnés, et les tarifs publics de cette architecture n'ont pas encore été dévoilés.

Les forfaits de la plateforme Tavus reposent toujours sur des paliers d'utilisation mensuels. Ils comprennent une formule gratuite offrant 20 minutes de vidéo conversationnelle par mois, un forfait Starter à 22 $ par mois, un forfait Builder à 59 $ par mois, un forfait Growth à 397 $ par mois et une formule Business à 975 $ par mois.

Les développeurs utilisant les outils actuels peuvent entraîner des avatars visuels personnalisés à l'aide d'une courte vidéo d'entraînement ou d'un simple portrait de référence. La plateforme intègre des contrôles de sécurité stricts pour empêcher toute usurpation d'identité et tout usage abusif lors des sessions en direct.
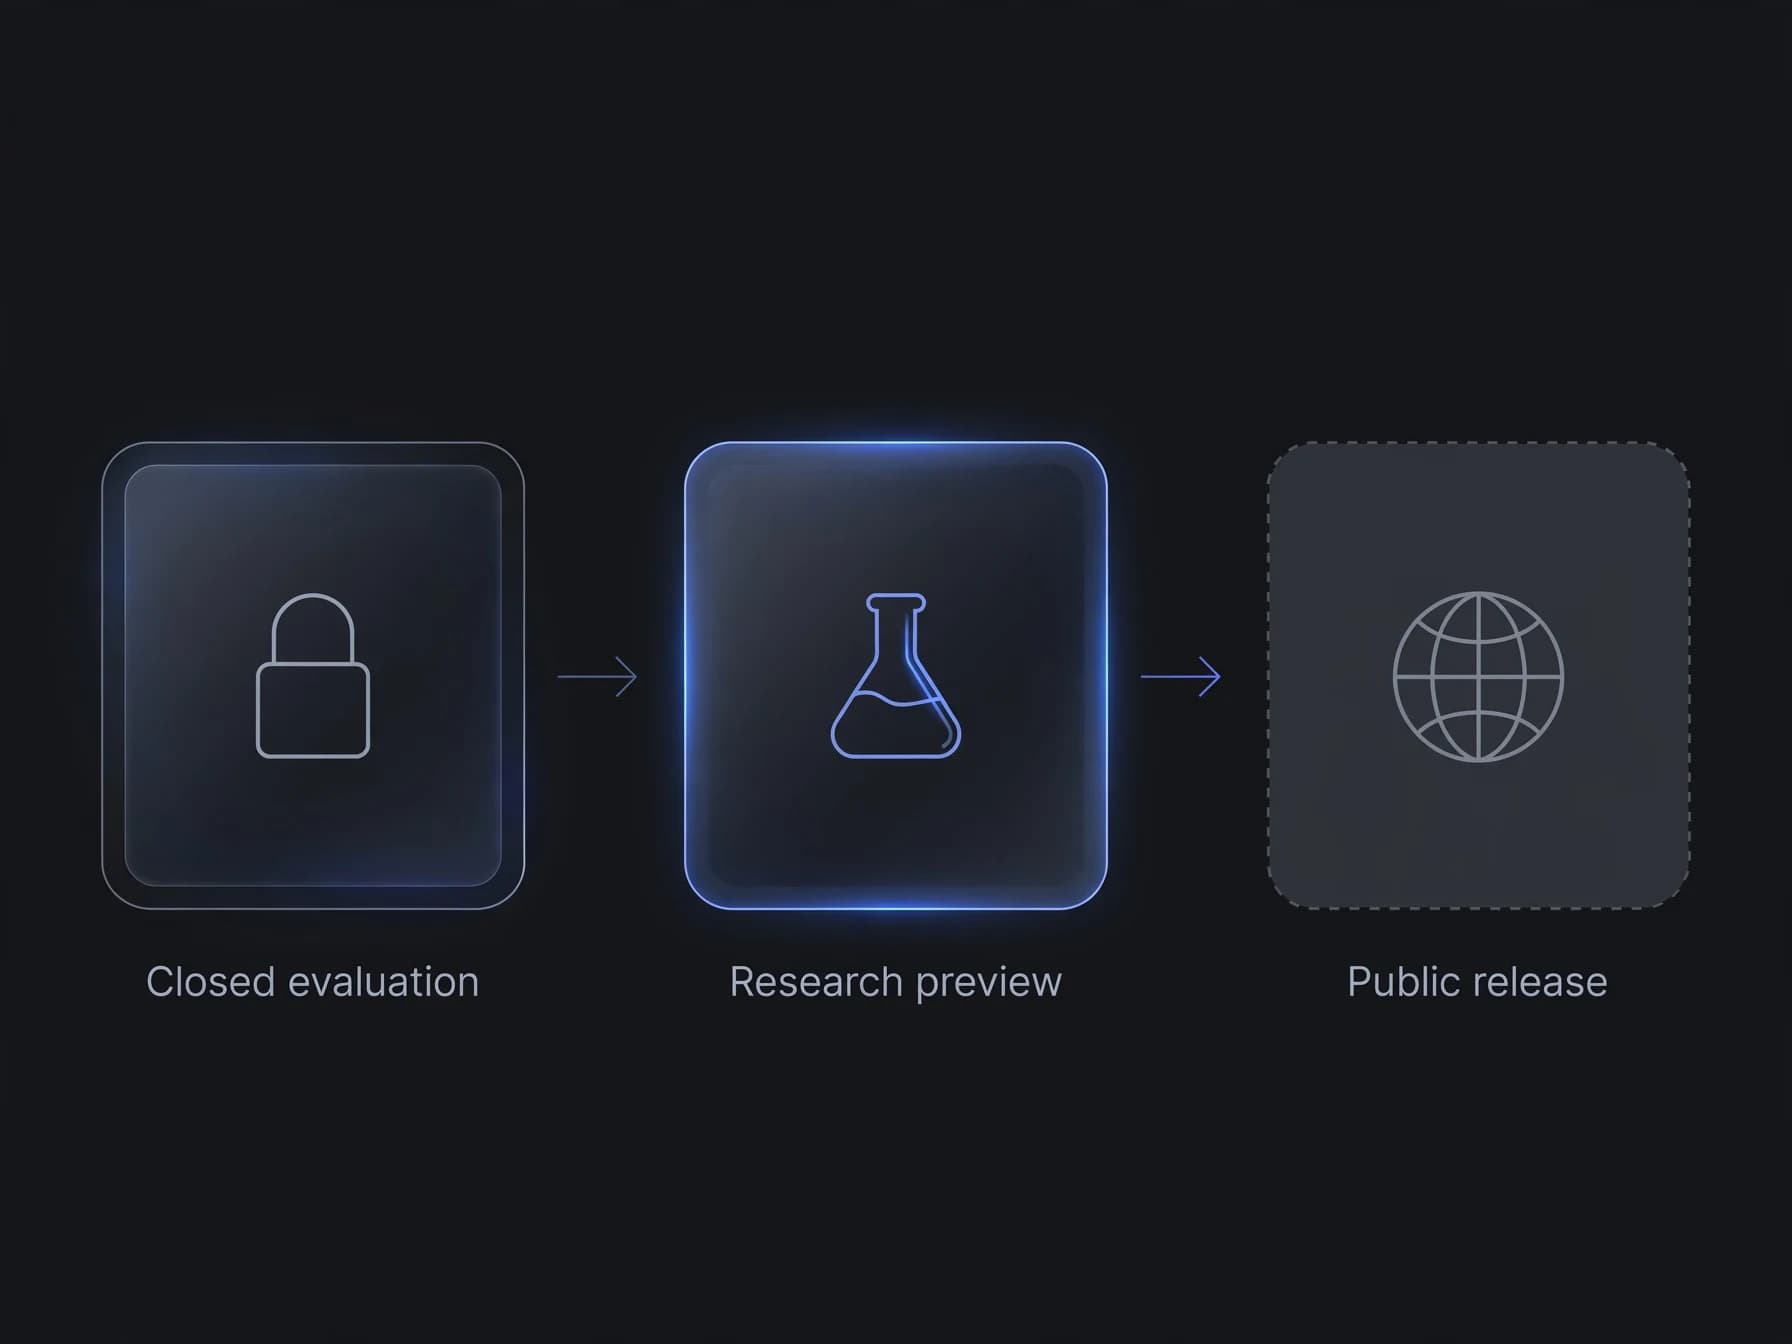
Calendrier de déploiement : évaluation fermée, aperçu de recherche et lancement public à venir

Outils de vidéo IA préenregistrée contre agents conversationnels en direct

Pour bien situer ces modèles conversationnels, il faut distinguer l'interaction en direct de la création vidéo classique. Les agents en direct privilégient des réponses ultra-rapides en moins de 200 millisecondes, au détriment des mouvements de caméra cinématiques et du guidage précis par prompt.

À l'inverse, les générateurs de vidéo préenregistrée mettent l'accent sur les détails visuels, les effets sonores et la maîtrise du style. Des plateformes comme OnVid vous permettent de créer des vidéos allant jusqu'à 60 secondes avec les forfaits Max à partir de descriptions textuelles ou de photos fixes, vous offrant une totale maîtrise du rythme et du cadrage.

Même si les avatars IA interactifs en temps réel figurent sur notre feuille de route chez OnVid, la production de vidéo préenregistrée reste la solution idéale pour vos vidéos marketing, vos réseaux sociaux et vos récits visuels. Découvrir les alternatives à Tavus et analyser les alternatives à HeyGen les plus utilisées vous aidera à choisir entre dialogue utilisateur en direct et production vidéo scénarisée.

Préparer vos processus aux systèmes de vidéo IA conversationnelle

Adopter des technologies comme Tavus Griffin commence par définir le rôle précis de votre agent automatisé. La vidéo interactive excelle dans le support client, les simulations de formation et l'assistance virtuelle en temps réel, où l'échange bidirectionnel est primordial.

La première étape consiste à évaluer vos exigences de latence pour vérifier si la diffusion en direct ou la vidéo précalculée correspond le mieux à vos objectifs. La deuxième étape vise à tester vos portraits avec un éclairage soigné pour que le rendu de l'avatar conserve des expressions stables lorsqu'il parle.

La troisième étape demande de définir des garde-fous conversationnels rigoureux afin que les personnalités de synthèse restent cohérentes durant les échanges avec les utilisateurs. Préparer ces éléments dès aujourd'hui garantit que votre équipe sera prête lors du déploiement public des plateformes de vidéo conversationnelle.
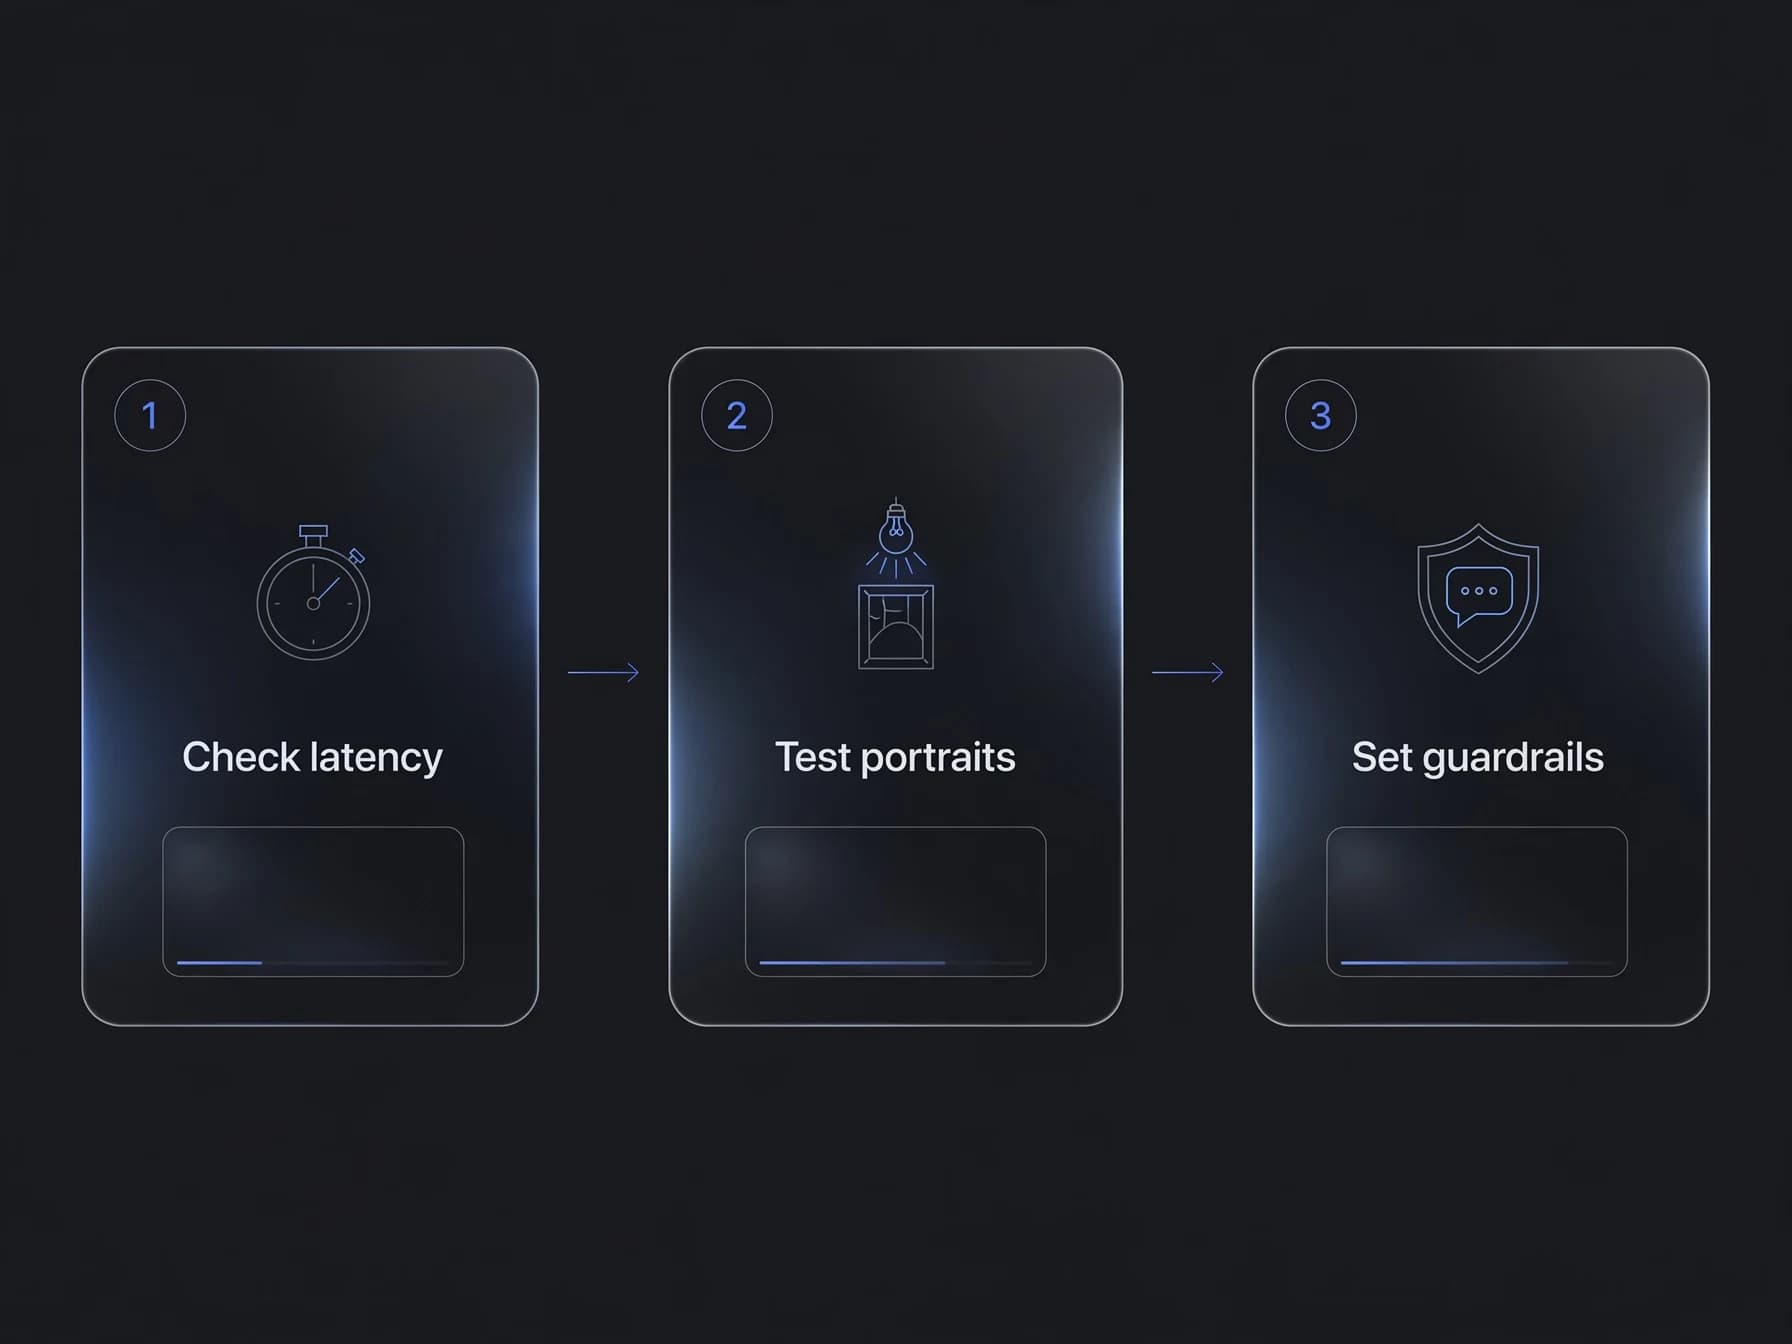
Préparation en 3 étapes pour la vidéo IA en direct : vérifier la latence, tester les portraits et fixer des garde-fous

Ce qu'il faut retenir sur Tavus Griffin en français

Tavus Griffin montre à quelle vitesse les modèles conversationnels réduisent l'écart de réalisme visuel, rapprochant les agents IA d'un échange humain naturel.

Bien que les tests de recherche affichent des temps de réponse et des scores de perception impressionnants, les créateurs doivent encore choisir entre fluidité conversationnelle et maîtrise visuelle. Suivre ces avancées vous aide à sélectionner les bons outils, alors que l'interaction en direct et la vidéo IA préenregistrée continuent d'évoluer.

Questions fréquentes sur Tavus Griffin

Obtenez des réponses claires sur les performances techniques, l'architecture et les limites de la version de recherche de Tavus Griffin et des agents conversationnels en direct.

Qu'est-ce que Tavus Griffin ?

Tavus Griffin est une architecture de modèle IA conçue pour des agents vidéo conversationnels en direct. Présenté le 1er octobre 2026, le modèle Tavus Griffin est pensé pour mener des échanges visuels bidirectionnels avec une latence minime et un rythme d'élocution proche de l'humain. Il marque le passage du rendu séquentiel traditionnel à une interaction continue et réactive.

Tavus Griffin a-t-il réussi le test de Turing en vidéo directe ?

Lors d'une étude à l'aveugle menée sur des appels vidéo d'une minute avec 54 participants, 48 % ont estimé que Tavus Griffin était un véritable être humain. C'est une nette progression par rapport au score précédent de 2,4 % (1 évaluateur sur 41). Sans tromper la totalité des participants, il s'agit du premier système documenté à frôler les 50 % de réussite lors d'un test de Turing visuel en temps réel.

Quels sont les résultats de Tavus sur le benchmark NVIDIA VideoFDB ?

L'architecture s'est hissée à la première place du benchmark NVIDIA VideoFDB dédié aux systèmes vidéo conversationnels. Elle a obtenu un score de génération visuelle de 3,83 contre 3,92 pour une référence humaine, et un score de perception de 3,73 contre 4,20 pour les humains. Ces métriques évaluent le naturel des expressions faciales, la direction du regard et les réactions d'écoute au fil de la discussion.

Qu'est-ce que la vidéo IA full duplex pour les agents conversationnels ?

La vidéo IA full duplex désigne un flux bidirectionnel continu dans lequel l'utilisateur et l'IA peuvent parler, écouter et s'interrompre à tout moment. Au lieu d'attendre la fin d'une phrase pour générer une réponse, le système traite le son reçu tout en générant simultanément les images vidéo. Cela permet d'intégrer des signaux d'écoute naturels, comme des hochements de tête ou de brèves approbations orales.

Comment l'architecture d'agent de Tavus IA est-elle structurée ?

La plateforme Tavus IA réunit plusieurs modèles spécialisés au sein d'agents interactifs appelés PAL. Le système standard associe Sparrow-2 pour la gestion des tours de parole, Phoenix-4.5 pour le rendu vidéo avec environ 134 millisecondes de latence, et Raven-1 pour la perception sensorielle. Le modèle Griffin regroupe la perception et la génération visuelle dans une solution unifiée.

En quoi OnVid diffère-t-il de Tavus Griffin ?

Contrairement à Tavus Griffin, OnVid crée des vidéos prêtes à télécharger à partir de texte ou de photos, sans appels interactifs, grâce à des modèles comme Seedance 2.5.

OnVid permet-il de créer des vidéos avec présentateur virtuel dès aujourd'hui ?

Oui. OnVid produit des vidéos de présentateurs avec synchronisation labiale à partir d'une photo portrait via OmniHuman ou Kling IA Avatar v2 sur notre générateur de photo parlante.

Quels modèles alimentent la génération texte en vidéo sur OnVid ?

OnVid intègre les meilleures options comme Seedance 2.5, Kling 2.5 Turbo et Google Veo. Les crédits sont décomptés à la seconde et les échecs sont remboursés.

Tavus Griffin est-il accessible au public dès maintenant ?

Tavus propose Griffin-Lite uniquement en version de recherche fermée pour une sélection de partenaires et de testeurs. L'architecture complète n'est pas encore accessible dans l'outil PAL Maker en libre-service ni via les API publiques. Les tarifs officiels et la date de lancement général n'ont pas encore été annoncés.

Combien coûte Tavus pour des agents vidéo conversationnels standards ?

Tavus propose des forfaits allant d'une formule de base à des solutions d'entreprise sur mesure. Consultez notre guide pour connaître le détail des offres.

Combien coûte OnVid pour générer des vidéos IA ?

L'inscription vous permet de tester la plateforme avant de choisir un abonnement. Le forfait Pro est proposé à 7,99 $ par semaine ou 14,99 $ par mois, et le forfait Max à 14,99 $ par semaine ou 28,99 $ par mois. Ces deux abonnements payants vous permettent de télécharger des vidéos HD sans filigrane, avec des crédits décomptés selon le modèle et la durée de la vidéo.

Pouvez-vous utiliser des vidéos générées par IA pour des projets commerciaux ?

L'usage commercial dépend du modèle utilisé. Vérifiez les conditions d'utilisation d'OnVid et celles du modèle choisi avant toute exploitation commerciale.

Tavus peut-il créer des avatars personnalisés à partir d'une seule photo ?

Tavus permet de créer des répliques numériques à partir d'une simple photo ou d'un court extrait vidéo de référence. Une fois entraîné, le visage personnalisé peut être intégré dans des agents conversationnels PAL pour automatiser vos échanges. Pour les contenus préenregistrés, des outils comme OnVid transforment un simple portrait photo en vidéo parlante grâce à des modèles de synchronisation labiale.

Où trouver des alternatives à Tavus pour la création vidéo ?

Consultez notre comparatif complet des alternatives à Tavus pour mesurer les différences entre agents conversationnels en temps réel et outils de génération asynchrone. Si vous avez besoin de vidéos marketing prêtes à l'emploi, de clips narratifs ou de publications pour les réseaux sociaux, tournez-vous plutôt vers des générateurs texte en vidéo ou image en vidéo. Votre choix dépend de votre besoin : appels vidéo en direct ou fichiers vidéo à télécharger.

Que mesure un test de Turing vidéo en intelligence artificielle ?

Un test de Turing vidéo évalue si des participants humains peuvent distinguer un avatar IA d'une vraie personne lors d'un flux vidéo en direct. Les participants échangent au cours d'une courte conversation pour juger de la cohérence visuelle, des micro-expressions du visage et du temps de réponse. Pour réussir, le système doit supprimer les temps de latence, les mouvements de lèvres non naturels et les pauses rigides.

Comment les modèles vidéo conversationnels gèrent-ils les interruptions ?

Les systèmes conversationnels modernes utilisent des modèles de perception audio intégrés pour détecter la voix humaine lorsque l'avatar s'exprime. Dès que vous prenez la parole, le pipeline interrompt immédiatement le rendu vidéo et l'avatar adopte une posture d'écoute attentive. Cette réactivité évite que l'avatar ne parle en même temps que vous et assure un dialogue naturel.

Voir des blogs similaires

More from the blog

Explorer plus