12 novembre 2026
9 min di lettura
Industry Insights

Tavus Griffin: il primo test di Turing video superato con l'IA

Tavus Griffin è un modello di video IA conversazionale interattivo progettato per gestire videochiamate in tempo reale con alternanza naturale del dialogo, movimenti facciali fluidi e tempi di risposta vocale inferiori al secondo. In recenti test alla cieca dal vivo, il 48% dei partecipanti ha creduto che l'avatar digitale fosse una persona vera dopo un'interazione di un minuto.

Di Revisionato da Jonah WellerCome revisioniamo

Cos'è Tavus Griffin e come funziona?

Tavus Griffin segna un'evoluzione importante nei media sintetici affrontando un test di Turing video dal vivo, ideato per misurare il realismo conversazionale. Sviluppato da Tavus, Griffin è un'architettura avanzata creata per dare vita a persone digitali che parlano, ascoltano e reagiscono durante videochiamate bidirezionali.

I modelli video tradizionali creano filmati in sequenza partendo da indicazioni di testo o foto statiche. Griffin adotta un approccio diverso: trasmette in streaming espressioni facciali fluide, dialoghi parlati e reazioni spontanee in contemporanea, elaborando al tempo stesso la voce di chi parla dal vivo.

Presentata il 1° ottobre 2026, questa tecnologia punta ad azzerare il distacco tra filmati sintetici pre-registrati e interazioni video dinamiche. Riproduce le microespressioni del viso e un ritmo vocale accurato, permettendo ai presentatori digitali di sostenere conversazioni prolungate con cadenza del tutto naturale.

I test benchmark su Tavus Griffin rispetto alle prestazioni umane

Durante una rigorosa valutazione con test di Turing per l'IA, i ricercatori hanno verificato se utenti comuni riuscissero a distinguere in tempo reale un sistema automatizzato da una persona in carne e ossa. Durante una prova di videochiamata dal vivo di un minuto con 54 partecipanti umani, il 48% ha creduto di parlare con un interlocutore reale. La versione precedente di Tavus aveva convinto appena il 2,4% degli esaminatori (uno su 41).

Il sistema ha conquistato anche il primo posto nel benchmark conversazionale NVIDIA VideoFDB, registrando un punteggio di realismo visivo pari a 3,83 rispetto al 3,92 dei video umani, e una valutazione di percezione di 3,73 a fronte del 4,20 umano.

Questi risultati evidenziano come la generazione video in tempo reale si stia avvicinando alla parità percettiva nelle brevi interazioni. Anche se i dialoghi più lunghi lasciano ancora intravedere dettagli sintetici, gli scambi brevi riproducono ormai la presenza umana con notevole affidabilità.
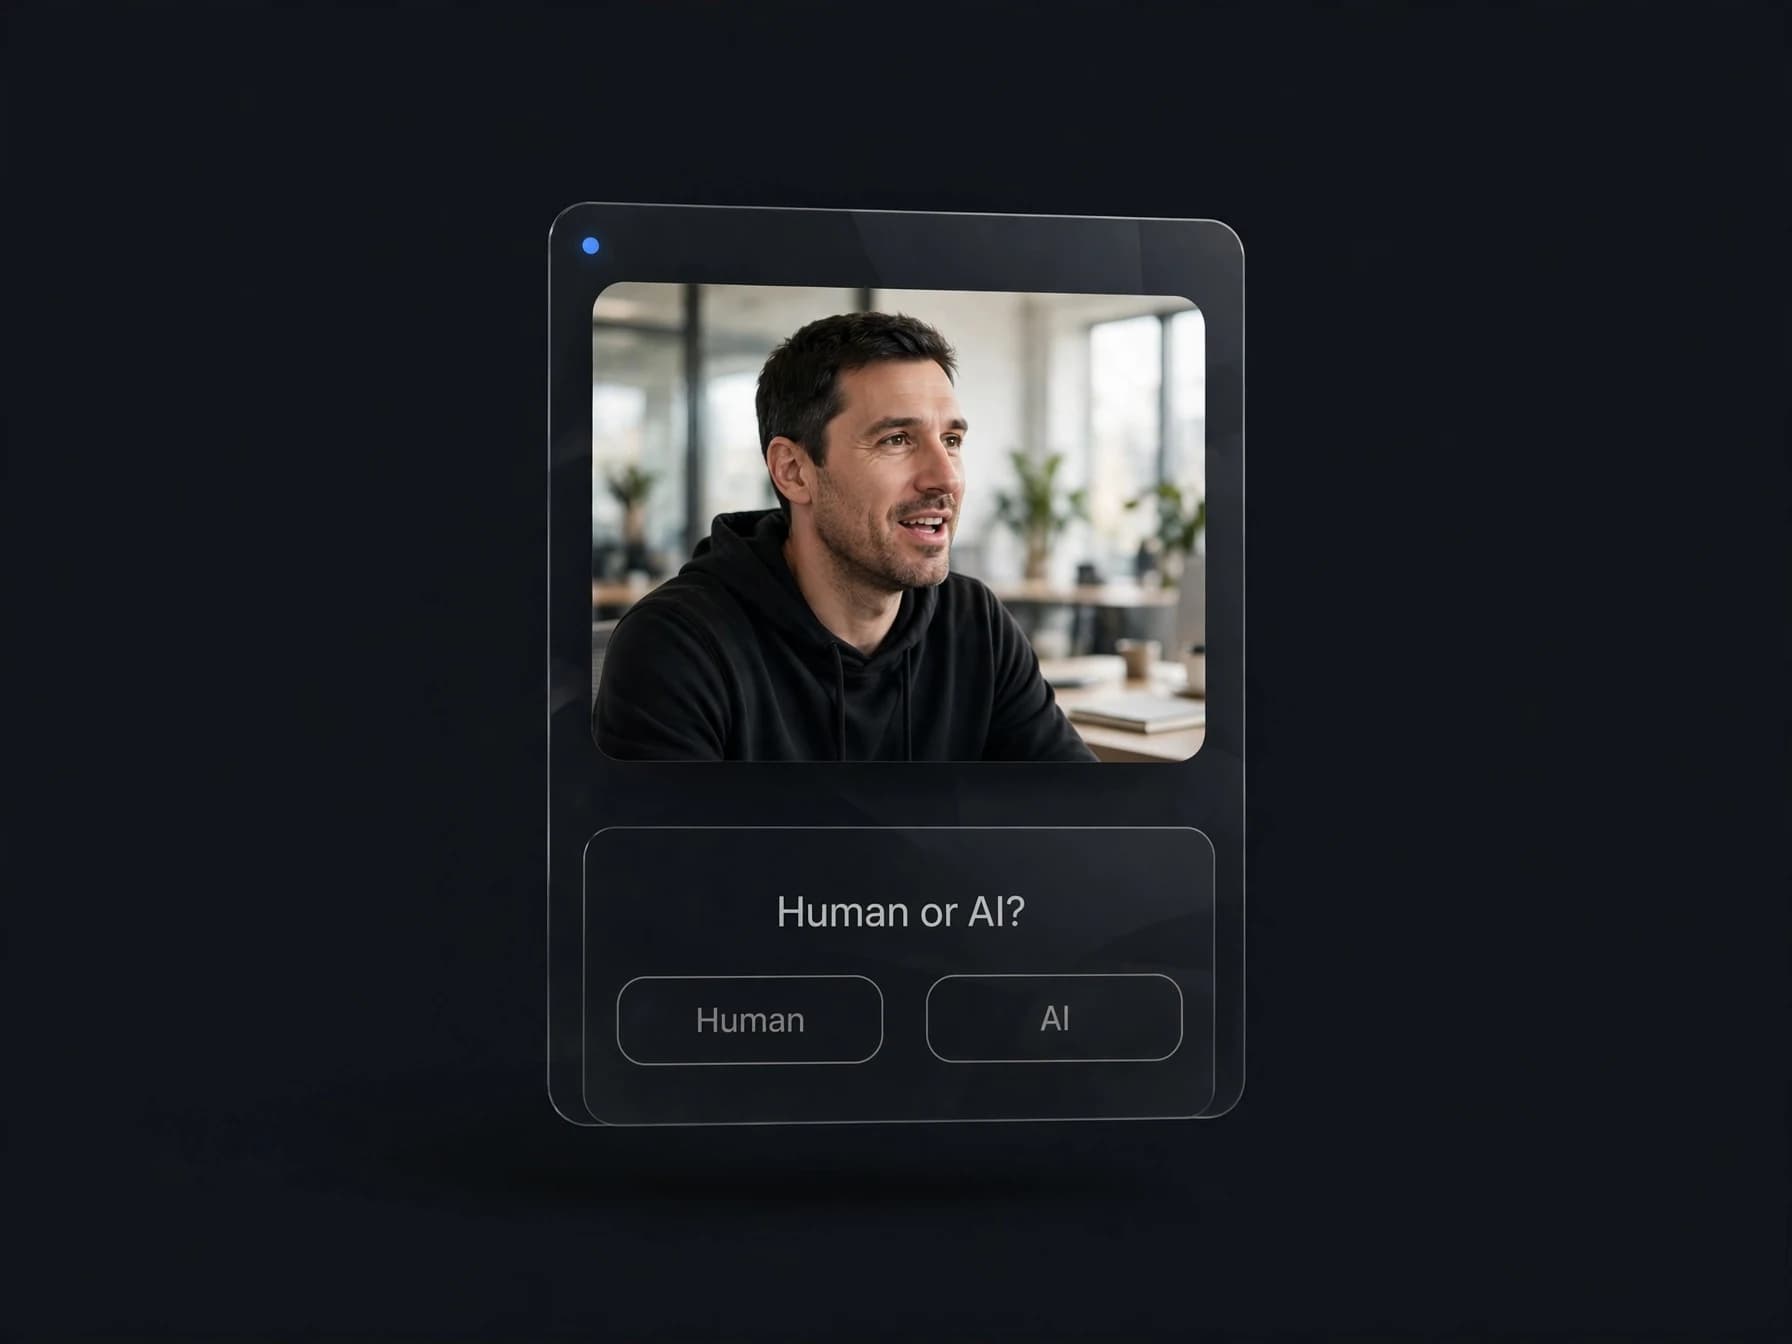
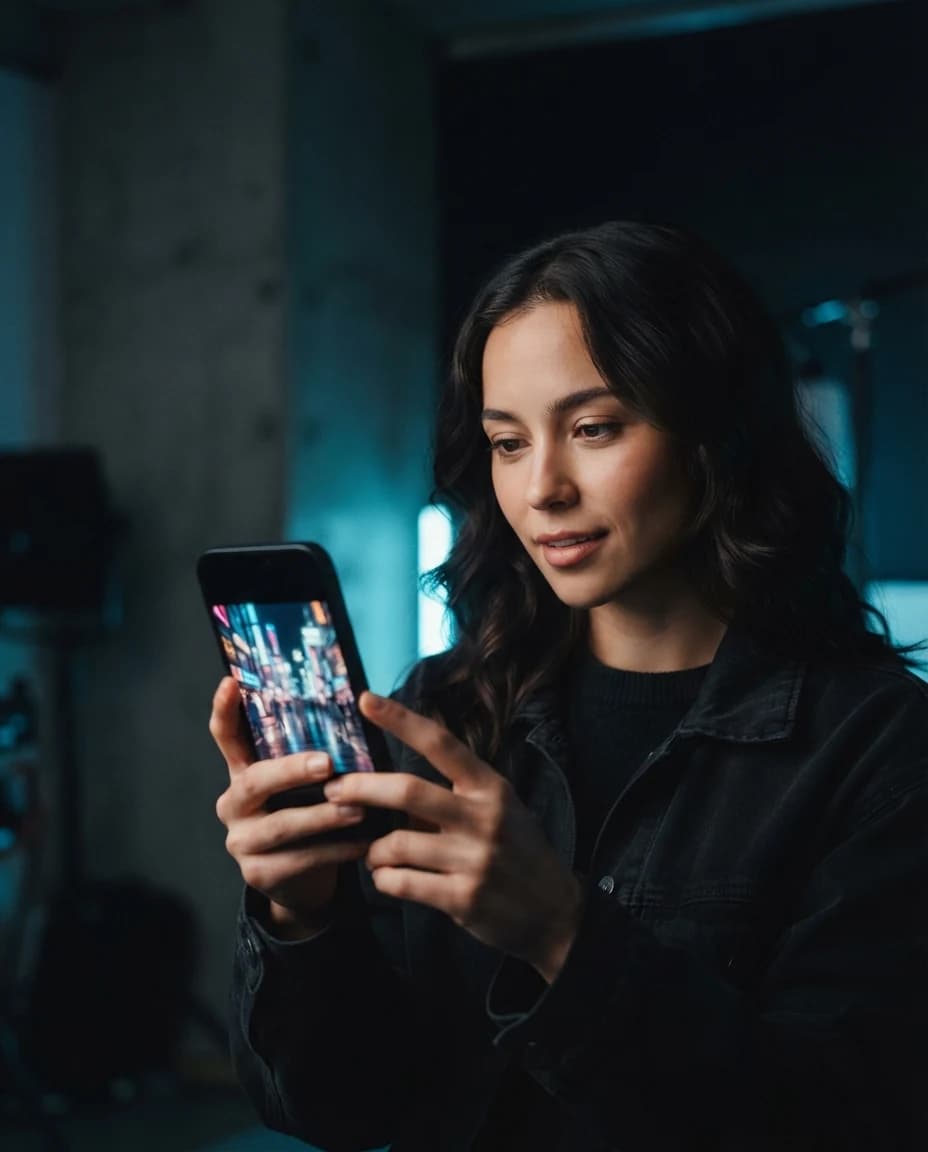
Videochiamata dal vivo con scheda di sondaggio che chiede agli utenti se chi parla sia un umano o un'IA

L'architettura streaming per gli agenti video conversazionali IA

L'implementazione di un avatar IA reattivo in tempo reale richiede una perfetta sincronizzazione tra la generazione visiva dei fotogrammi e gli stimoli conversazionali istantanei. Tavus gestisce l'intero processo attraverso moduli dedicati che controllano comprensione, tempi vocali e resa visiva.

La pipeline impiega Raven-1 per la percezione sensoriale e Sparrow-2 per la gestione dei turni di parola e delle interruzioni. Il rendering è affidato a Phoenix-4.5 con una bassissima latenza di circa 134 millisecondi, mentre Griffin cura la modellazione facciale ad alta fedeltà e l'adattamento costante all'ambiente.

Grazie a questa architettura, gli sviluppatori possono creare agenti capaci di fermarsi quando vengono interrotti e riprendere a parlare con spontaneità. Mentre gli strumenti dedicati ai creator, come un generatore di avatar IA, realizzano video parlanti pre-registrati a partire da foto, le architetture conversazionali si concentrano esclusivamente sullo streaming a bassissima latenza.

Come accedere a Tavus Griffin e disponibilità della piattaforma

L'accesso all'intero sistema IA Tavus Griffin resta limitato, poiché l'azienda sta svolgendo valutazioni chiuse. Al momento solo Griffin-Lite è disponibile come anteprima di ricerca per sviluppatori selezionati, e i prezzi pubblici per questa architettura non sono ancora stati annunciati.

I piani generali della piattaforma Tavus continuano a basarsi su livelli di utilizzo mensile. Comprendono un piano Free da 20 minuti di video conversazionale al mese, uno Starter a 22 $ al mese, un Builder a 59 $ al mese, un Growth a 397 $ al mese e un piano Business a 975 $ al mese.

Gli sviluppatori che usano le funzioni attuali possono addestrare personaggi visivi personalizzati tramite un breve video di training o un singolo ritratto di riferimento. La piattaforma include controlli di sicurezza rigorosi per evitare la replica non autorizzata del volto e usi impropri durante le sessioni in diretta.
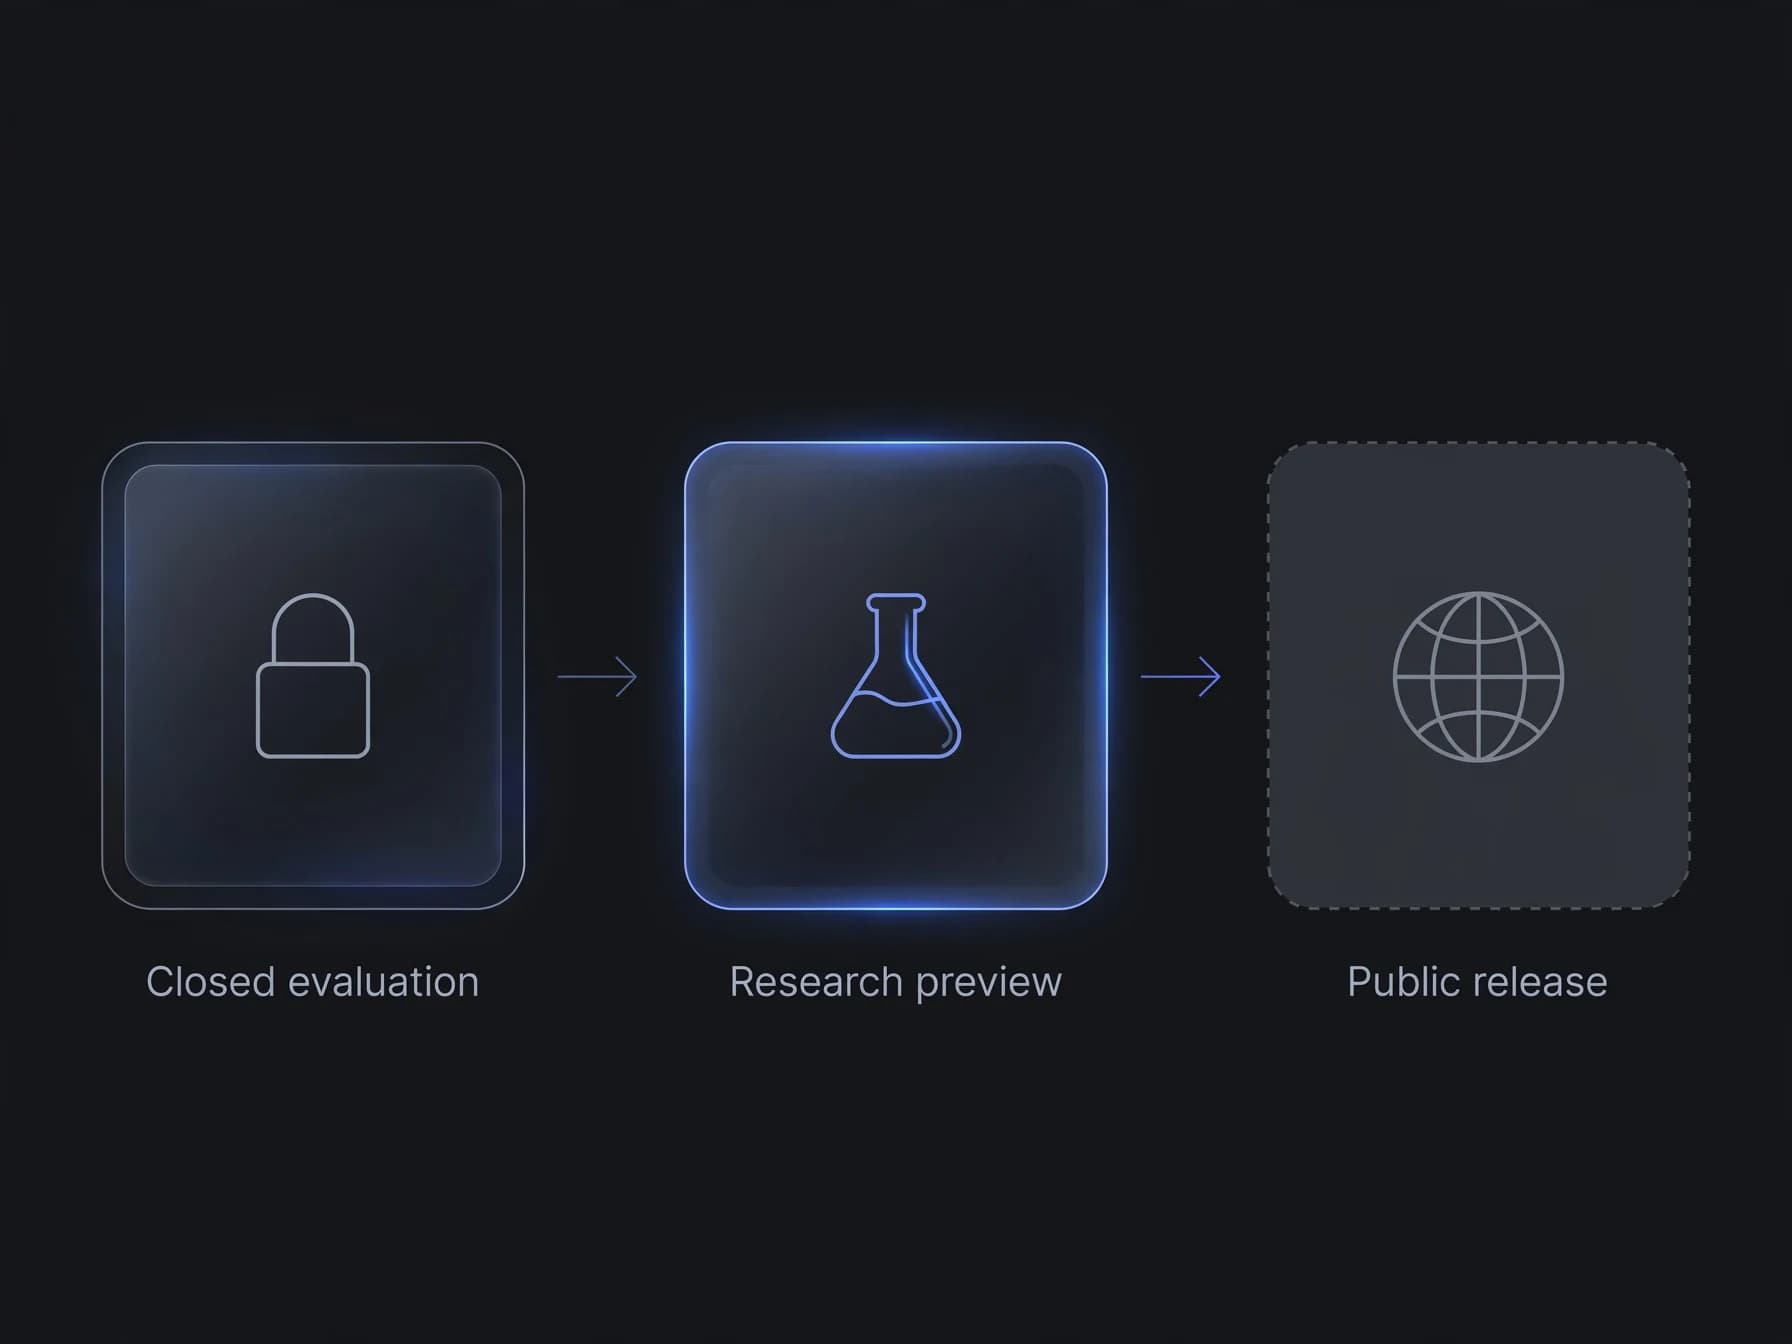
Cronologia dell'accesso: valutazione chiusa, anteprima di ricerca e rilascio pubblico non ancora avvenuto

Strumenti per video IA preregistrati e agenti conversazionali live

Per capire dove si collocano i modelli conversazionali, occorre distinguere l'interazione in tempo reale dalla creazione video tradizionale. Gli agenti dal vivo danno priorità a risposte rapide sotto i 200 millisecondi, rinunciando al controllo cinematografico della videocamera e alla regia dettagliata dei prompt.

Al contrario, i generatori di video preregistrati puntano sulla massima cura visiva, sugli effetti sonori e sul controllo dello stile. Piattaforme come OnVid ti permettono di generare video fino a 60 secondi sui piani Max partendo da prompt di testo o da foto statiche, lasciandoti il controllo diretto su ritmo e composizione della scena.

Anche se gli avatar IA interattivi in tempo reale sono nella nostra roadmap di OnVid, la creazione di video preregistrati resta la scelta più pratica per video di marketing, contenuti social e storytelling. Esplorare le alternative a Tavus e confrontare le più note alternative a HeyGen ti aiuterà a capire se il tuo progetto richiede un dialogo live con l'utente o una produzione video guidata da un copione.

Come preparare il flusso di lavoro per i video IA con Tavus Griffin

Adottare tecnologie come la pipeline video di Tavus Griffin inizia dalla definizione del ruolo del tuo agente automatico. I video interattivi danno il meglio nell'assistenza clienti, nelle simulazioni di formazione e nel supporto virtuale dal vivo in cui lo scambio reciproco è fondamentale.

Il passo 1 consiste nel verificare i requisiti di latenza, capendo se lo streaming live o il video pre-renderizzato risponde meglio ai tuoi obiettivi. Il passo 2 richiede di testare ritratti con un'illuminazione pulita, così che i modelli di rendering dell'avatar mantengano lineamenti stabili mentre parlano.

Il passo 3 richiede l'inserimento di regole conversazionali chiare, per mantenere affidabili i personaggi sintetici durante le interazioni dal vivo. Preparare questi elementi oggi permette al tuo team di farsi trovare pronto man mano che le piattaforme di video conversazionale diventeranno accessibili a tutti.
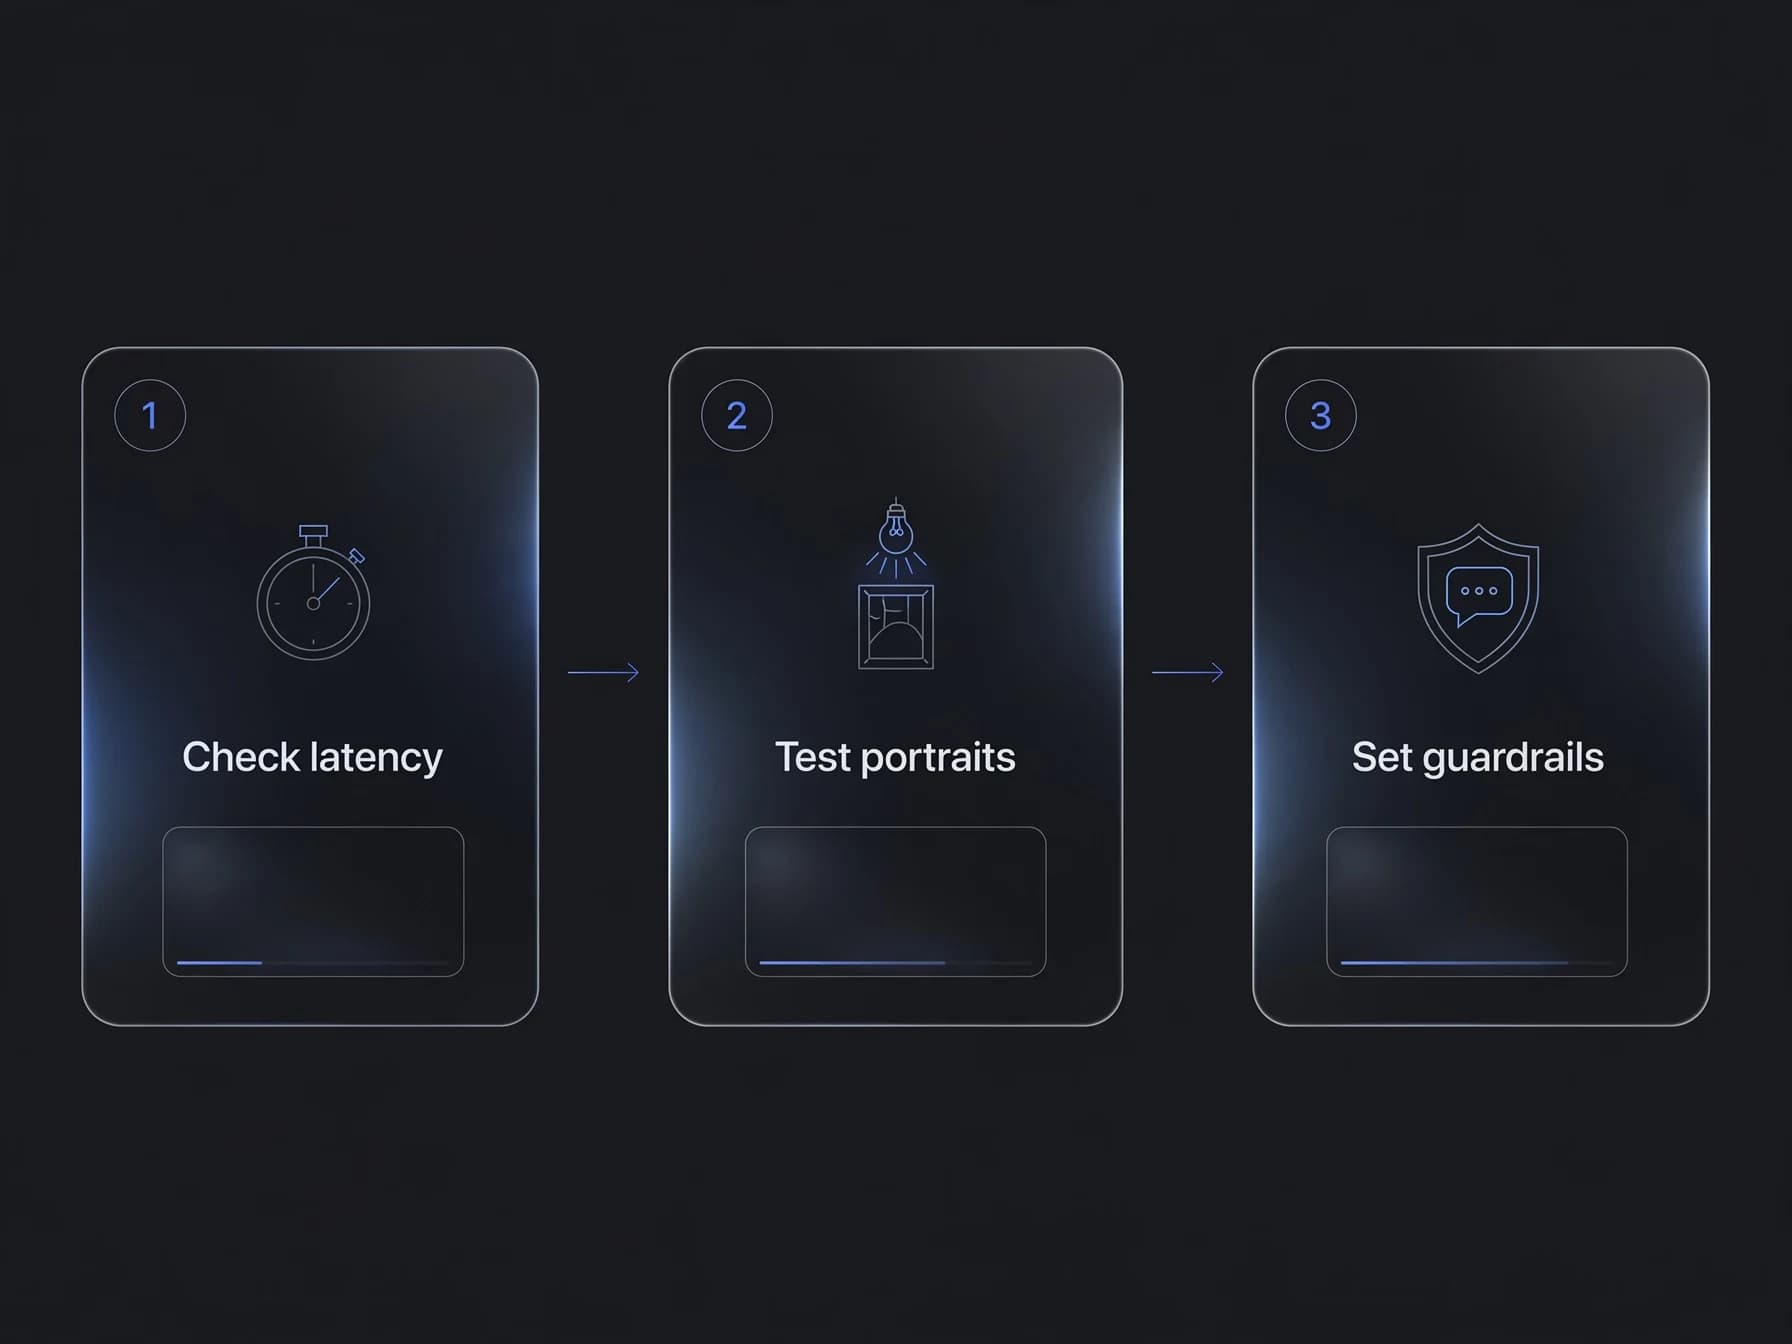
Preparazione in tre passaggi per i video IA live: verifica latenza, test dei ritratti, impostazione regole

Punti chiave su Tavus Griffin in italiano

Tavus Griffin dimostra quanto rapidamente i modelli conversazionali stiano colmando il divario di realismo visivo, portando gli agenti IA interattivi sempre più vicini alla naturalezza umana.

Anche se i benchmark di ricerca evidenziano un'ottima gestione dei turni di parola e punteggi di percezione elevati, chi crea contenuti deve ancora bilanciare la conversazione dinamica con un controllo visivo affidabile. Seguire questi traguardi ti aiuta a scegliere gli strumenti ideali man mano che l'interazione in tempo reale e i video IA pre-renderizzati continuano a evolversi.

Domande frequenti su Tavus Griffin

Trova risposte chiare sui benchmark tecnici, l'architettura e i limiti della versione di ricerca di Tavus Griffin e degli agenti conversazionali in tempo reale.

Che cos'è Tavus Griffin?

Tavus Griffin è un'architettura di modelli IA sviluppata per agenti video conversazionali in tempo reale. Annunciato il 1° ottobre 2026, il modello Tavus Griffin è progettato per gestire interazioni visive bidirezionali a bassa latenza, con tempi di risposta naturali e simili a quelli umani. Segna il passaggio dal rendering tradizionale a turni a un'interazione continua e reattiva.

Tavus Griffin ha superato il test di Turing in video dal vivo?

In uno studio in cieco su videochiamate di un minuto con 54 persone, il 48% dei partecipanti ha creduto che Tavus Griffin fosse una persona reale. Si tratta di un netto passo avanti rispetto al precedente stack di Tavus, fermo al 2,4% (1 valutatore su 41). Pur non ingannando tutti i partecipanti, è il primo sistema documentato a raggiungere percentuali vicine al 50% in un test di Turing visivo in tempo reale.

Come si è comportato Tavus nel benchmark NVIDIA VideoFDB?

L'architettura si è classificata al primo posto nel benchmark NVIDIA VideoFDB per i sistemi video conversazionali. Ha ottenuto un punteggio di generazione visiva di 3,83 rispetto al valore umano di riferimento di 3,92, e un punteggio di percezione di 3,73 contro 4,20 degli umani. Questi parametri misurano la naturalezza delle espressioni, della direzione dello sguardo e delle reazioni di ascolto durante il dialogo.

Cos'è il video IA full duplex negli agenti conversazionali?

Il video IA full duplex è uno streaming bidirezionale continuo in cui sia l'umano che l'IA possono parlare, ascoltare e interrompere in qualsiasi momento. Anziché aspettare la fine di una frase per elaborare la risposta, il sistema gestisce l'audio in ingresso mentre genera contemporaneamente i fotogrammi video. Questa architettura consente feedback naturali in tempo reale, come cenni del capo e conferme verbali.

Come struttura il proprio stack di agenti Tavus IA?

La piattaforma nota come Tavus IA combina modelli specializzati in agenti conversazionali chiamati PAL. Il flusso standard sfrutta Sparrow-2 per l'alternanza dei turni di dialogo, Phoenix-4.5 per la generazione video con circa 134 millisecondi di latenza e Raven-1 per la percezione sensoriale. Il modello più recente Griffin integra percezione e generazione visiva in un unico sistema conversazionale.

In cosa si differenzia uno strumento come OnVid rispetto a Tavus Griffin?

A differenza di Tavus Griffin, OnVid punta su video pre-renderizzati scaricabili da prompt di testo o foto anziché su chiamate dal vivo, sfruttando modelli come Seedance 2.5.

OnVid permette di creare video con presentatori parlanti?

Sì. OnVid crea video pre-renderizzati con presentatori parlanti e lip sync da una singola foto ritratto, usando modelli avatar come OmniHuman e Kling IA Avatar v2 sul nostro generatore da foto a video.

Quali modelli alimentano OnVid per la funzione testo in video?

OnVid offre modelli di punta come Seedance 2.5, Kling 2.5 Turbo e Veo 3.1. I crediti sono conteggiati al secondo e le generazioni non riuscite vengono rimborsate in automatico.

Tavus Griffin è già disponibile per il pubblico?

Tavus ha reso disponibile Griffin-Lite solo come anteprima di ricerca riservata per partner e tester selezionati. L'architettura completa non è ancora accessibile nel PAL Maker self-service o tramite API pubbliche. I prezzi ufficiali e le tempistiche di rilascio generale non sono ancora stati annunciati.

Quanto costa Tavus per gli agenti video conversazionali standard?

Tavus propone piani che vanno da un livello base a soluzioni aziendali personalizzate. Consulta la nostra guida dedicata per tutti i dettagli su tariffe e soglie di utilizzo.

Quanto costa OnVid per generare video IA?

Registrandoti puoi provare la piattaforma prima di attivare un abbonamento. Il piano Pro è disponibile a 7,99 $ a settimana o 14,99 $ al mese, mentre Max costa 14,99 $ a settimana o 28,99 $ al mese. Entrambi offrono download in HD senza filigrana e scalano i crediti in base al modello e alla durata del video.

È possibile usare i video generati con l'IA per progetti commerciali?

L'uso commerciale dipende dal modello usato per creare il video. Verifica i Termini di servizio di OnVid e le condizioni del singolo modello prima dell'uso.

Tavus può creare avatar personalizzati a partire da una sola foto?

Tavus supporta la creazione di repliche digitali personalizzate a partire da una singola foto o da un breve video di riferimento. Una volta elaborato, il volto personalizzato può essere usato negli agenti conversazionali PAL per interazioni automatiche con gli utenti. Per contenuti pre-renderizzati, strumenti come OnVid animano singoli ritratti fotografici in video parlanti grazie a modelli di sincronizzazione labiale.

Dove trovare le migliori alternative a Tavus per produrre video?

Leggi la nostra rassegna dettagliata sulle alternative a Tavus per confrontare gli agenti conversazionali in tempo reale con i generatori asincroni. I progetti che richiedono video promozionali completi, clip narrative o post social sfruttano al meglio i generatori da testo in video e da immagine a video. La scelta dipende dalla tua necessità di fare videochiamate dal vivo o esportare file video da scaricare.

Cosa misura il test di Turing per i video nell'intelligenza artificiale?

Un test di Turing applicato ai video valuta se le persone riescono a distinguere un avatar IA da un individuo reale durante una videochiamata dal vivo. I partecipanti conversano per valutare coerenza visiva, microespressioni facciali e tempi di risposta. Il successo si ottiene azzerando i ritardi di latenza, i movimenti innaturali delle labbra e le pause rigide.

In che modo i modelli video conversazionali gestiscono le interruzioni?

I moderni sistemi conversazionali usano modelli di percezione audio integrati per rilevare la voce umana mentre l'avatar sta parlando. Se l'utente interviene, il sistema interrompe subito il rendering del video e rimette l'avatar in posizione di ascolto. Questa risposta rapida impedisce all'avatar di parlare sopra l'utente e mantiene naturale l'interazione.

Vedi blog simili

More from the blog

Esplora di più