Tavus Griffin: O Que É e Como Funciona?
O Tavus Griffin representa um avanço marcante nas mídias sintéticas ao encarar um teste de Turing em vídeo ao vivo feito para avaliar o realismo conversacional. Desenvolvido pela Tavus, o Griffin é uma arquitetura de modelo conversacional avançada feita para dar vida a personas digitais que falam, ouvem e reagem durante chamadas de vídeo bidirecionais.
Os modelos de vídeo tradicionais criam vídeos em sequência a partir de comandos de texto ou fotos estáticas. O Griffin funciona de forma diferente: ele transmite movimentos faciais fluidos, diálogos falados e reações sutis ao mesmo tempo em que processa o áudio de quem está falando ao vivo.
Anunciada em 1º de outubro de 2026, a tecnologia busca diminuir a distância entre vídeos sintéticos pré-gravados e interações de vídeo em tempo real. O modelo reproduz microexpressões faciais e ritmo vocal preciso para que apresentadores digitais mantenham conversas longas em vídeo com fluidez natural.
Tavus Griffin: Como os Testes de Desempenho Avaliaram o Modelo
Durante uma avaliação rigorosa do teste de Turing com IA, pesquisadores testaram se observadores comuns conseguiam distinguir um sistema automatizado de uma pessoa de verdade em tempo real. Em chamadas de vídeo ao vivo de um minuto com 54 participantes humanos, 48% acreditaram estar falando com uma pessoa real. Em comparação, a versão anterior do Tavus convenceu apenas 2,4% dos participantes, ou um em cada 41 avaliadores.
O sistema também conquistou o primeiro lugar no benchmark conversacional NVIDIA VideoFDB. Ele registrou uma pontuação de realismo de geração de 3,83, contra 3,92 de vídeos humanos, e uma classificação de percepção de 3,73, diante dos 4,20 obtidos por humanos.
Esses números mostram que a geração de vídeo em tempo real está atingindo paridade perceptiva em interações curtas. Embora conversas mais longas ainda mostrem imperfeições sintéticas, diálogos breves já reproduzem a presença humana de maneira convincente e consistente.
A estrutura de streaming por trás dos agentes de vídeo IA conversacionais
Implementar um avatar de IA em tempo real responsivo requer sincronizar a geração de quadros visuais com sinais imediatos de conversa. O Tavus coordena essa experiência por meio de sistemas especializados que cuidam da compreensão, do ritmo da fala e da saída visual.
O fluxo usa o Raven-1 para percepção sensorial e o Sparrow-2 para alternância de falas e controle de interrupções. A renderização fica a cargo do Phoenix-4.5, com baixa latência em torno de 134 milissegundos, enquanto o Griffin entrega modelagem facial de alta fidelidade e adaptação contínua ao ambiente.
Essa arquitetura permite aos desenvolvedores criar agentes de conversa que pausam ao serem interrompidos e voltam a falar com naturalidade. Enquanto ferramentas de criação como um gerador de avatar IA criam vídeos falantes pré-gravados a partir de fotos, as arquiteturas conversacionais se concentram exclusivamente no streaming de baixa latência.
Como acessar o Tavus Griffin e disponibilidade atual
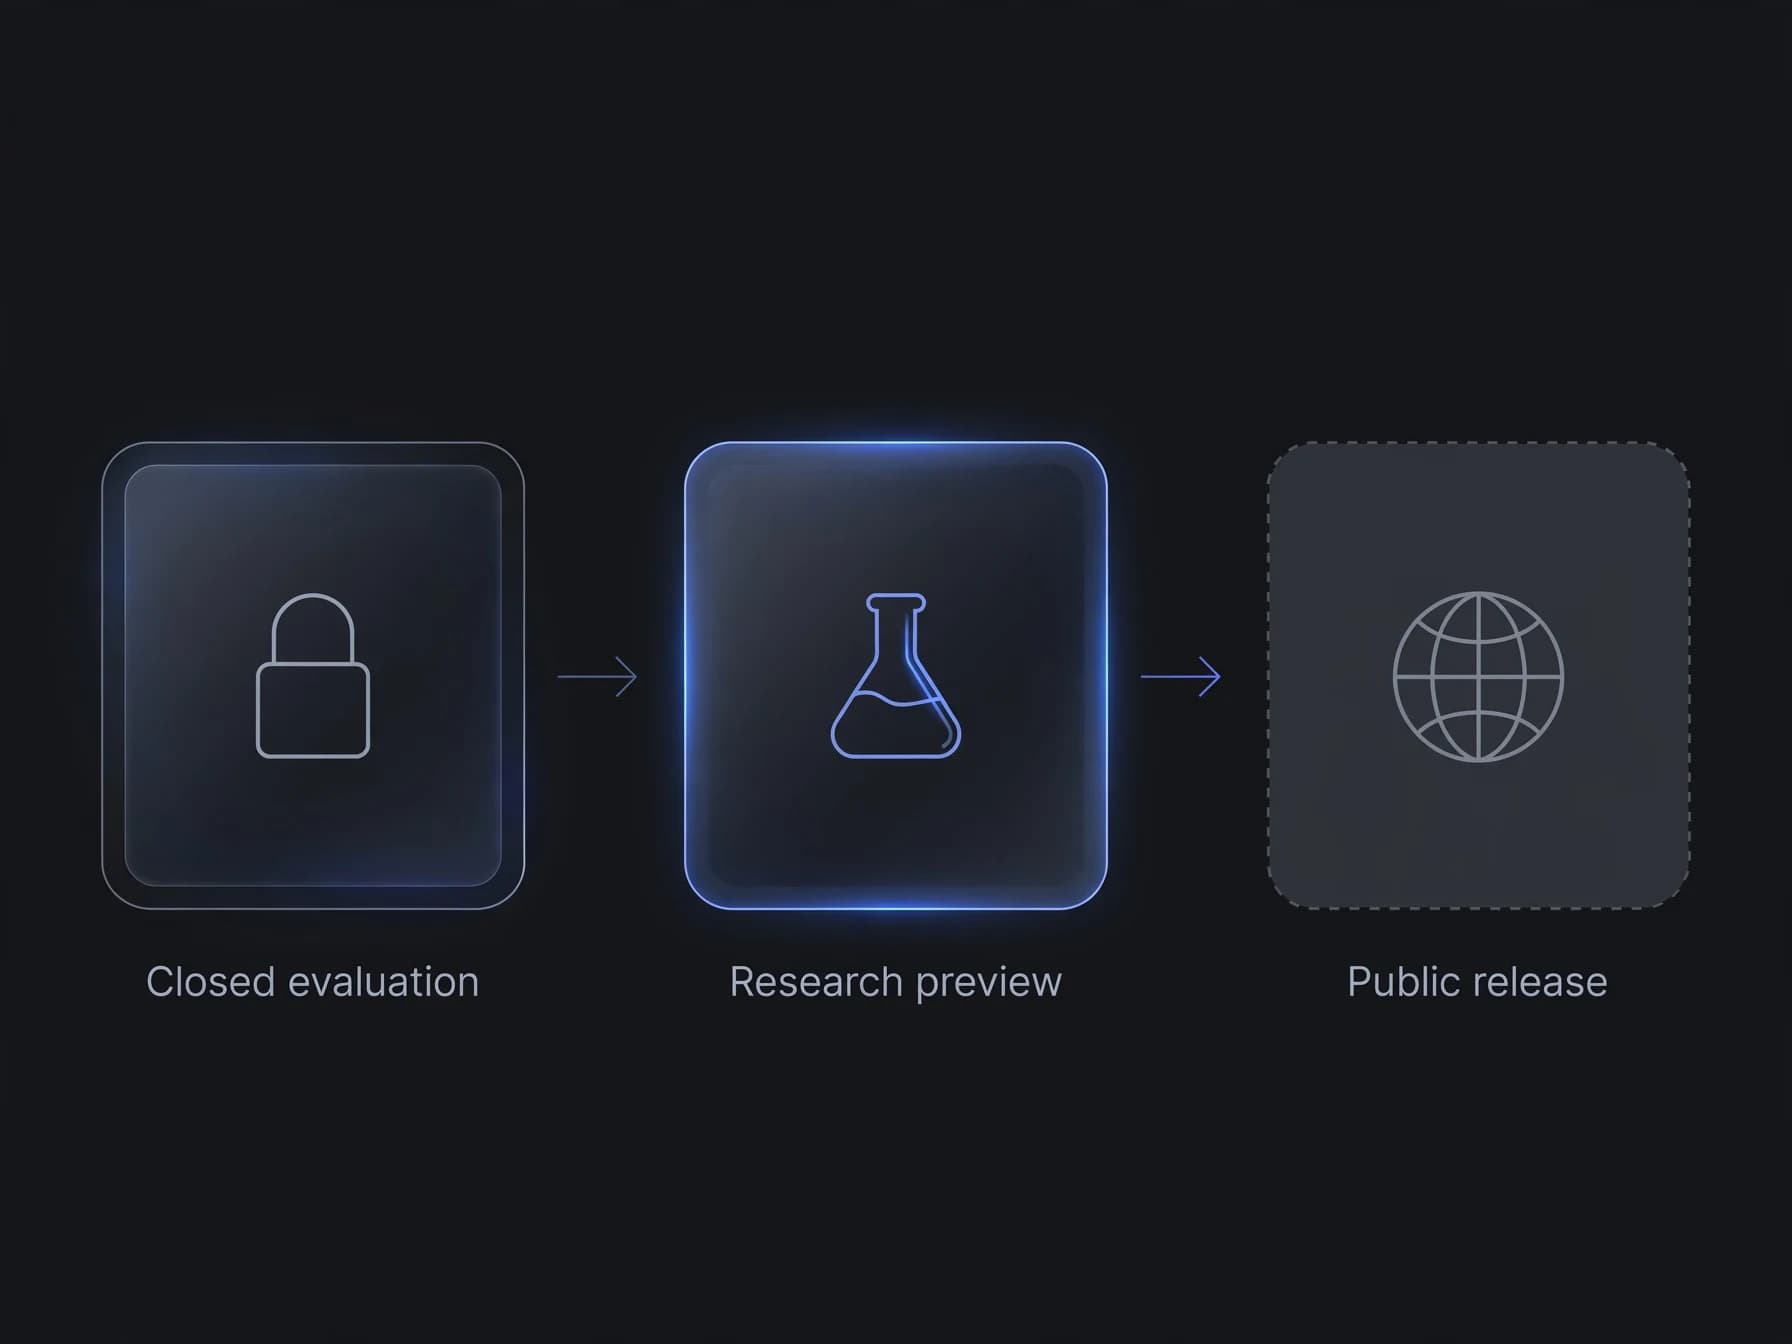
O acesso ao sistema completo de IA do Tavus Griffin continua limitado, enquanto a empresa realiza avaliações fechadas. No momento, apenas o Griffin-Lite está disponível como uma prévia de pesquisa para desenvolvedores selecionados, e os preços públicos da arquitetura ainda não foram anunciados.
Os planos gerais da plataforma Tavus continuam organizados em níveis de uso mensal. Eles incluem um plano gratuito que oferece 20 minutos de vídeo conversacional por mês, um plano Starter por US$ 22 mensais, um nível Builder por US$ 59 mensais, um nível Growth por US$ 397 mensais e um plano Business por US$ 975 mensais.
Os desenvolvedores que usam os recursos atuais da plataforma podem treinar personas visuais personalizadas com um vídeo curto de treinamento ou apenas uma foto de referência. A plataforma traz verificações rígidas de segurança para evitar o uso indevido e a clonagem não autorizada de imagem durante transmissões ao vivo.
Ferramentas de vídeo IA pré-gravado versus agentes conversacionais ao vivo
Para entender onde os modelos conversacionais se encaixam, é preciso separar a interação em tempo real da criação tradicional de vídeos. Os agentes ao vivo priorizam respostas rápidas abaixo de 200 milissegundos, abrindo mão do controle cinematográfico de câmera e da direção de prompts complexos.
Em compensação, os geradores de vídeo pré-gravado focam no máximo de detalhes visuais, efeitos sonoros e controle de estilo. Plataformas como o OnVid permitem que você gere vídeos de até 60 segundos nos planos Max a partir de textos ou fotos estáticas, dando controle direto sobre o ritmo e a composição da cena.
Embora avatares de IA interativos em tempo real estejam no nosso radar no OnVid, a criação de vídeos pré-gravados continua sendo a escolha mais prática para peças de marketing, redes sociais e narrativas visuais. Conhecer alternativas ao Tavus e comparar alternativas ao HeyGen populares ajuda você a decidir se o seu projeto precisa de conversas ao vivo ou de uma produção de vídeo roteirizada.
Preparando seu fluxo de trabalho para o Tavus Griffin e vídeos conversacionais
Adotar tecnologias como a estrutura de vídeo do Tavus Griffin começa pela definição do papel que o seu agente automatizado terá. O vídeo interativo funciona melhor em suporte ao cliente, treinamentos práticos com simulações e assistência virtual ao vivo, onde a resposta em duas vias é fundamental.
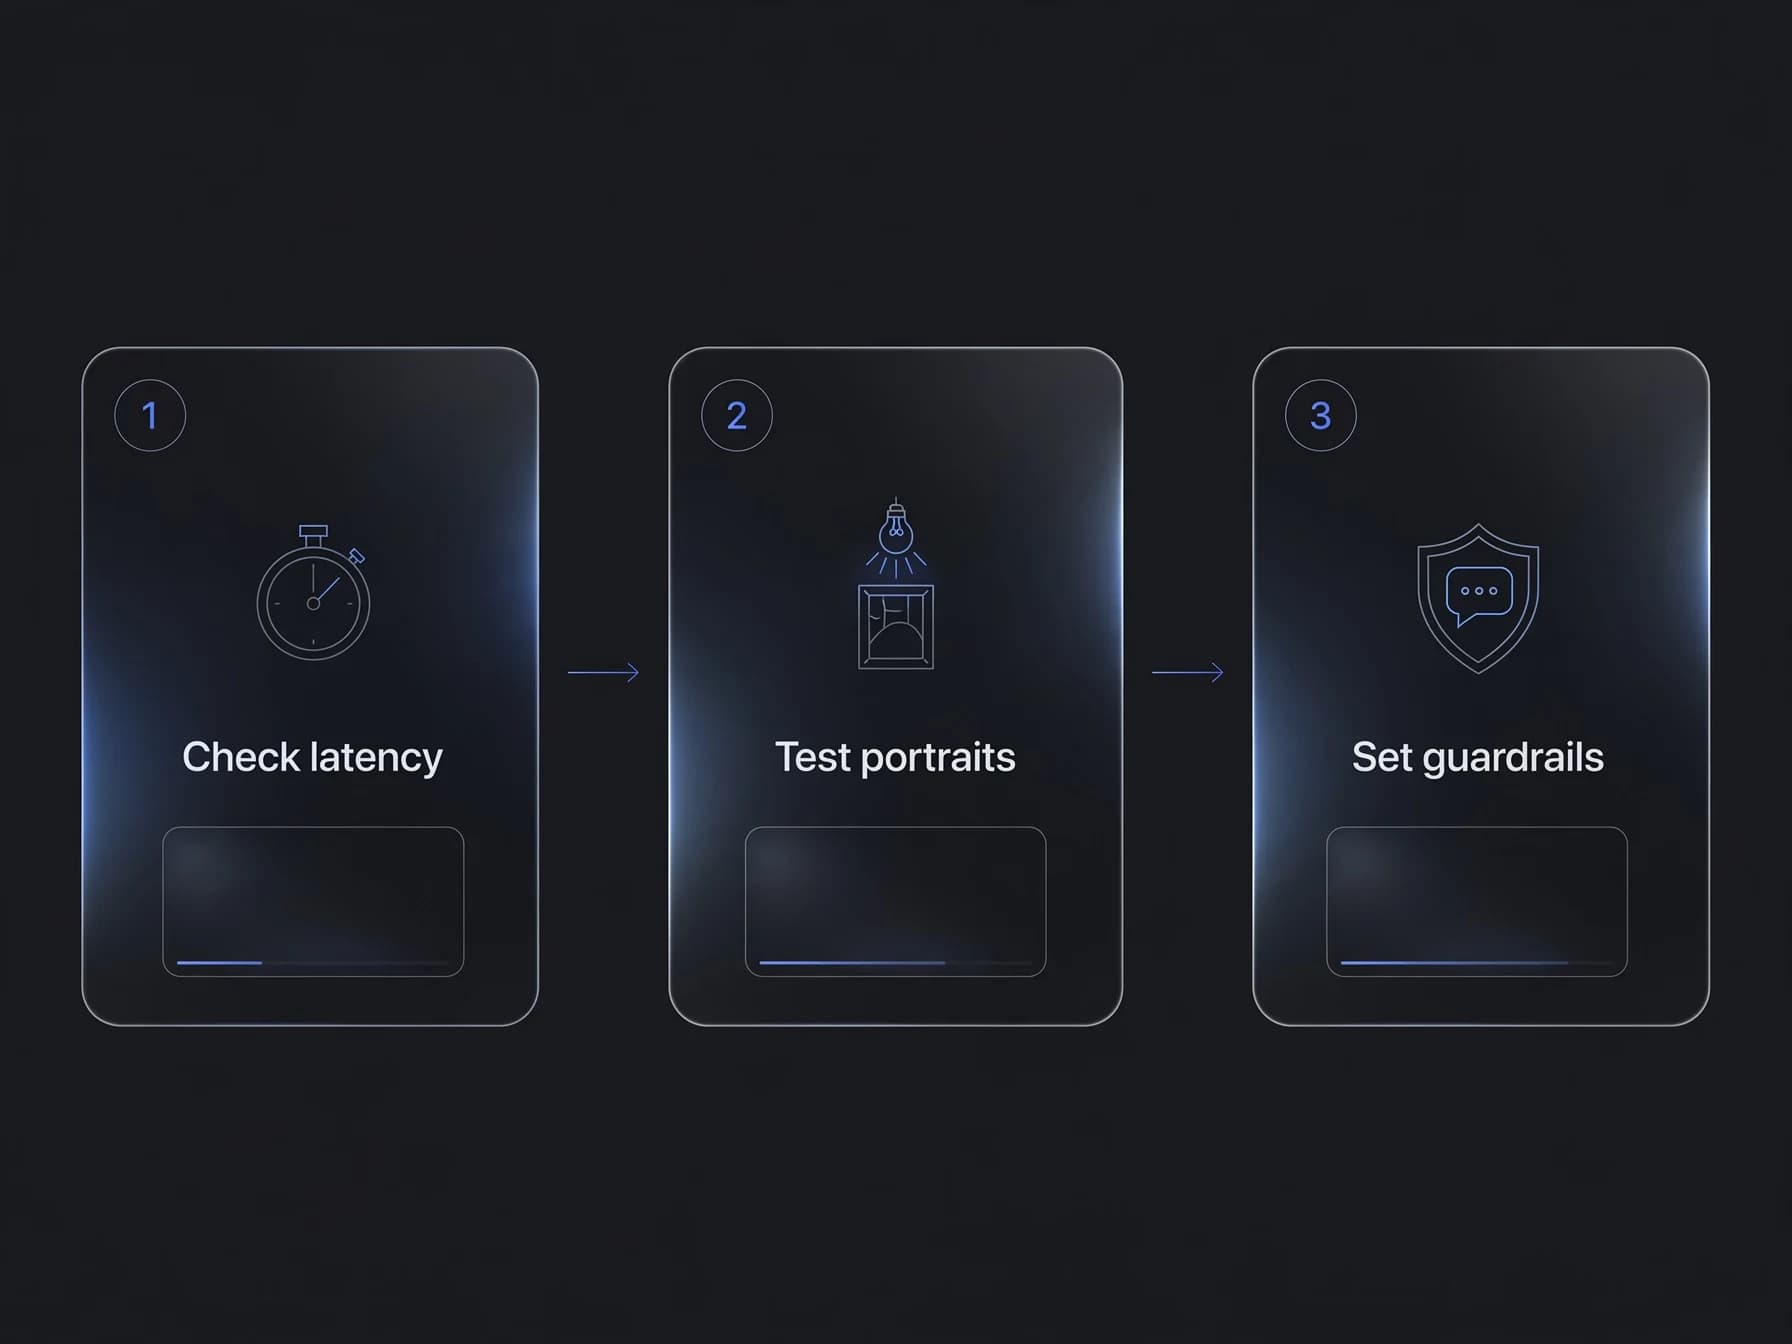
O passo 1 é analisar as exigências de latência para decidir se a transmissão ao vivo ou o vídeo pré-renderizado atende melhor aos objetivos do seu projeto. O passo 2 envolve testar fotos com iluminação limpa, garantindo que os modelos de renderização do avatar mantenham traços faciais consistentes enquanto falam.
O passo 3 exige estabelecer regras claras de conversa, para que as personas sintéticas continuem confiáveis durante as interações ao vivo com os usuários. Preparar esses materiais hoje garante que sua equipe esteja pronta quando as plataformas de vídeo conversacional chegarem a um público maior.